เมื่อ AI ทุกตัวฉลาดพอแล้ว ผลิตภัณฑ์ยังเหลืออะไรให้แข่งขัน? | CEO Insights
เมื่อ GPT-6, Claude, Gemini และ Grok ต่างฉลาดพอแล้ว อะไรยังทำให้ผลิตภัณฑ์ AI แตกต่างได้อีก? Porsche Tsai ซีอีโอของ OakMega ชำแหละสนามแข่งขันถัดไป จาก Model สู่ Context, Action และ Trust
 Porsche TsaiCEO
สารบัญ
- บทเรียนจากแมคโดนัลด์
- การเปิดตัวระลอกนี้ ล้วนพูดถึงเรื่องเดียวกัน
- คูเมืองกำลังย้ายที่: จาก Model สู่ Context
- ความไว้วางใจกำลังกลายเป็นโจทย์การออกแบบผลิตภัณฑ์
- “โมเดลที่ดีที่สุด” อาจไม่ใช่คำตอบเลยก็ได้
- OakMega: Context, Action และ Trust ครบในที่เดียว
- FAQ
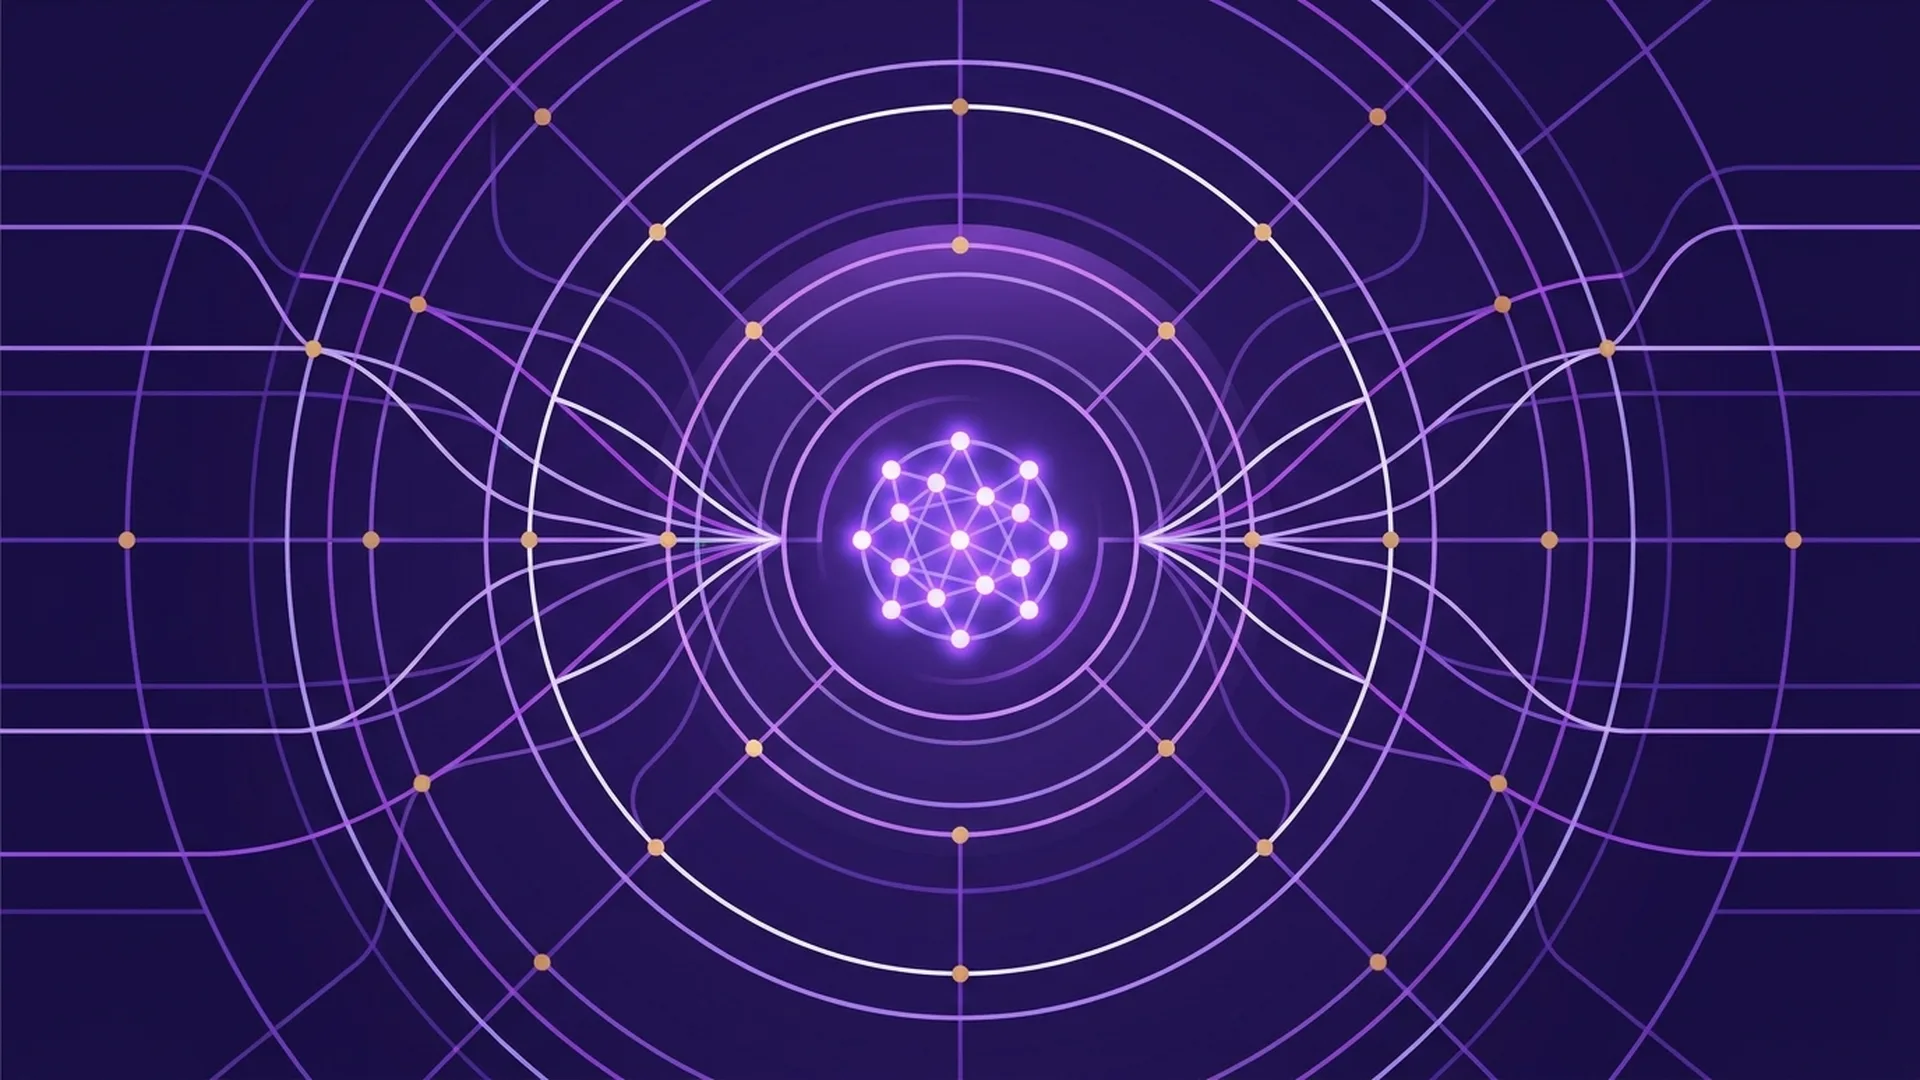 ความฉลาดที่แผ่ขยายจากแกนกลางเพียงจุดเดียว ออกไปเป็นเครือข่ายของบริบทและการลงมือทำทั้งระบบ โมเดลเป็นเพียงจุดเริ่มต้น การแข่งขันที่แท้จริงอยู่ที่ทุกสิ่งที่งอกงามขึ้นรอบตัวมัน
บทเรียนจากแมคโดนัลด์
ตั้งแต่ปี 2021 แมคโดนัลด์จับมือกับ IBM ทดสอบระบบไดรฟ์ทรู “สั่งอาหารด้วยเสียงผ่าน AI” ในสาขามากกว่า 100 แห่งในสหรัฐฯ วิสัยทัศน์ฟังดูน่าสนใจมาก ลูกค้าไม่ต้องตะโกนสั่งอาหารใส่ลำโพงซ้ำไปซ้ำมาอีกต่อไป AI จะเข้าใจ รับออร์เดอร์ และคิดเงินให้เอง โดยมีแผนจะขยายไปทั่วประเทศ
แต่ไม่นานนัก คลิปความผิดพลาดก็เริ่มเป็นไวรัล AI ฟังลูกค้าผิด เพิ่มนักเก็ตไก่ในออร์เดอร์เดียวจนพุ่งไปถึง 260 ชิ้น ใส่เบคอนและเนยลงในไอศกรีม และไม่ว่าลูกค้าจะพยายามแก้ไขแค่ไหน มันก็ไม่เข้าใจ (หนึ่งในคลิปที่ถูกแชร์มากที่สุด เป็นภาพลูกค้าตะโกนใส่ลำโพง ขณะที่ AI ทวนออร์เดอร์อย่างร่าเริงว่ามีชาหวานเก้าแก้ว ซันเดย์คาราเมลใส่เบคอน และนักเก็ตมูลค่าราว US$222 ทั้งที่เธอไม่ได้สั่งสักอย่าง) หลังจากคลิปเหล่านี้ระเบิดบน TikTok และ Twitter แมคโดนัลด์ก็ประกาศยุติการทดสอบในเดือนมิถุนายน 2024 (CNBC) เครื่องในสาขาทดสอบกว่า 100 แห่งถูกถอดออกทั้งหมดภายในสิ้นเดือนกรกฎาคมปีนั้น และกลับไปใช้พนักงานรับออร์เดอร์ตามเดิม (Al Jazeera)
ตอนที่ผมอ่านเรื่องนี้ สิ่งที่ผมได้ไม่ใช่ข้อสรุปว่า “AI ใช้ไม่ได้” แต่คือ มันเผยให้เห็นสิ่งที่ลึกกว่านั้น ไม่ว่าความฉลาดจะสูงแค่ไหน ก็ไม่ได้แปลว่าจะไว้วางใจให้มันลงมือทำงานในระดับสเกลได้ ต่อให้ระบบรู้จำเสียงเก่งเพียงใด ถ้าขาดบริบทที่เพียงพอ (เสียงรบกวนรอบข้าง ลูกค้าต้องการอะไรจริง ๆ ควรส่งต่อให้คนเมื่อไร) และไม่มีกลไกให้ลูกค้าหยุดหรือแก้ไขได้ทุกเมื่อ ระบบที่ฉลาดที่สุดก็อาจกลายเป็นหายนะที่ถูกถ่ายคลิปและแชร์ไปทั่วอินเทอร์เน็ตได้
คำถามนี้ยังเป็นคำถามเดียวกับที่ผมสลัดไม่หลุด หลังจากได้ดูงานเปิดตัวของแล็บ AI รายใหญ่ครบทั้งรอบในช่วงไม่กี่สัปดาห์ที่ผ่านมา: เมื่อความสามารถของโมเดลไล่ตามกันทันอย่างรวดเร็ว อะไรคือสิ่งที่ยังเหลือให้ผลิตภัณฑ์ AI สร้างความแตกต่างได้?
สรุปสั้น ๆ ก่อน: เมื่อความฉลาดของ GPT, Claude, Gemini และ Grok ไล่ตามกันทันอย่างรวดเร็ว ความแตกต่างของผลิตภัณฑ์ AI กำลังย้ายออกจาก “โมเดลฉลาดแค่ไหน” ไปสู่สามเรื่อง ได้แก่ Context ที่มันมี สิทธิ์ในการ Action ที่มันได้รับ และ Trust ที่ผู้ใช้ยอมมอบให้ โมเดลจะกลายเป็นสินค้าโภคภัณฑ์ต่อไปเรื่อย ๆ แต่สามชั้นนี้จะไม่เป็นเช่นนั้น
การเปิดตัวระลอกนี้ ล้วนพูดถึงเรื่องเดียวกัน
ในช่วงสี่ถึงหกสัปดาห์ที่ผ่านมา ผู้เล่นรายใหญ่แทบทุกรายเคลื่อนไปในทิศทางเดียวกัน GPT-6 Astra ของ OpenAI ไม่ได้ชูจุดขายว่า “คุยเก่งขึ้น” ฟีเจอร์หลักคือ Computer Use, Browser Use และความสามารถในการผลิตงานที่เสร็จสมบูรณ์อย่างเอกสาร สเปรดชีต และสไลด์นำเสนอ และเมื่อความต้องการเปลี่ยน มันจะปรับปรุงผลงานต่อไปแทนที่จะเริ่มใหม่ทั้งหมด SpaceXAI ไปไกลกว่านั้นอีก โดยวางตำแหน่ง Grok Bot ให้เป็น “เพื่อนร่วมทีม AI สำหรับองค์กร” Bot แต่ละตัวมีคอมพิวเตอร์บนคลาวด์ของตัวเอง ใช้งานเว็บไซต์และแอปได้เอง และยังทำงานต่อในเบื้องหลังแม้คุณจะล็อกเอาต์ไปแล้ว ส่วน Muse ของ Meta เน้นความเป็นส่วนตัวมากขึ้น แทนที่จะรอให้คุณถาม มันจะเรียนรู้บริบทของคุณอย่างต่อเนื่องและผลักดันเป้าหมายของคุณไปข้างหน้าเชิงรุก ขณะที่ Claude Fable 5.1 และ Mythos 5.1 ของ Anthropic ซึ่งเปิดตัวในช่วงเดียวกัน ก็มุ่งเน้นงานที่ใช้เวลานานและมีหลายขั้นตอน เช่น การเขียนโค้ด งานด้านความรู้ และการวิจัยทางวิทยาศาสตร์
เมื่อนำการเปิดตัวเหล่านี้มาวางเทียบกัน จะเห็นว่าไม่ใช่เรื่องบังเอิญ แต่เป็นการเปลี่ยนฉันทามติของทั้งอุตสาหกรรม: ในปี 2026 จุดโฟกัสของการแข่งขันได้ย้ายจาก “Intelligence” ไปสู่ “Execution” แล้ว เมื่อก่อนเราสนใจว่าโมเดลตอบได้ฉลาดหรือไม่ ตอนนี้ทุกคนสนใจว่ามันทำงานทั้งชิ้นให้เสร็จได้จริงหรือเปล่า
แต่เพราะทุกรายต่างเร่งไปสู่ “ทำงานได้มากขึ้น” คำถามที่แหลมคมกว่าเดิมจึงตามมา: ถ้า GPT, Claude, Gemini และ Grok ต่างฉลาดพอจะทำเวิร์กโฟลว์ทั้งหมดให้เสร็จได้ แล้วทำไมผู้ใช้จะต้องเลือกใช้ตัวใดตัวหนึ่งเป็นพิเศษ?
คูเมืองกำลังย้ายที่: จาก Model สู่ Context
คำตอบกำลังรวมศูนย์ไปที่แนวคิดเดียว: ใครเข้าใจ “งานที่อยู่ตรงหน้า” ได้ดีที่สุด
Claudeforce ที่ Salesforce และ Anthropic ประกาศเมื่อปลายเดือนสิงหาคม เป็นตัวอย่างที่ตรงไปตรงมาที่สุดเท่าที่ผมเคยเห็นมา แก่นของมันไม่ใช่การเปิดตัวโมเดลใหม่อีกตัวเลย แต่คือการเชื่อม Claude เข้ากับข้อมูลรายได้แบบเรียลไทม์ เวิร์กโฟลว์ ตรรกะทางธุรกิจ และกฎการกำกับดูแลของ Salesforce เอง “Salesforce in Claude” ระลอกแรกมาพร้อมทักษะด้านการขาย 37 รายการ ที่ทำให้ Claude วิเคราะห์ข้อมูล pipeline ที่อัปเดตสดได้โดยตรง อัปเดตสถานะดีล และดำเนินการภายใต้การกำกับดูแล สิ่งที่ทำให้ทักษะเหล่านี้มีคุณค่าไม่เคยอยู่ที่ว่าเบื้องหลังใช้โมเดลของบริษัทไหน ต่อให้สลับไปใช้โมเดลอื่นที่ฉลาดใกล้เคียงกัน ผลลัพธ์ก็ไม่ต่างกันมาก สิ่งที่มีค่าจริง ๆ คือข้อมูลและกฎที่ Salesforce ถือไว้ว่า “ความสัมพันธ์กับลูกค้าของบริษัทนี้หน้าตาเป็นอย่างไรกันแน่”
เรื่องนี้ยืนยันสูตรที่ผมเชื่อมั่นมากขึ้นเรื่อย ๆ:
Better AI ≠ Better Model Better AI Product = Model × Context × Tools × Memory
Context ในที่นี้หมายถึงชั้นข้อมูลและกฎที่ช่วยให้ AI Agent เข้าใจความสัมพันธ์กับลูกค้า ตรรกะทางธุรกิจ และกฎการกำกับดูแลอันเป็นเอกลักษณ์ของแต่ละบริษัท มันไม่ใช่ตัวโมเดล แต่เป็นชั้นที่อยู่นอกโมเดลซึ่งบอก Agent ว่า “ควรลงมือทำอย่างไร”
ความฉลาดของโมเดลอาจกลายเป็นสินค้าโภคภัณฑ์เร็วกว่าที่เราคิด บทวิเคราะห์ทางธุรกิจหลายชิ้นในปี 2026 ชี้ไปในทางเดียวกันว่า ตัวโมเดลเองกำลังกลายเป็น “ใครทำก็พอ ๆ กัน” อย่างรวดเร็ว และความได้เปรียบที่สะสมได้จริง ซึ่งไม่ระเหยหายไปทุกครั้งที่โมเดลอัปเกรด คือ “connectors, evaluation harnesses, agent orchestration และ guardrails” พูดง่าย ๆ ก็คือ Context และวิธีกำกับดูแล Context นั้น ซึ่งจริง ๆ แล้วก็เป็นอีกมุมหนึ่งของสิ่งที่เราพูดมาตลอดเรื่องข้อมูลฝั่งที่หนึ่ง (first-party data): ในยุค AI คุณค่าของข้อมูลลูกค้าไม่ได้อยู่ที่ “นำไปวิเคราะห์ได้” แต่อยู่ที่ว่า “มันช่วยให้ Agent รู้ว่าควรลงมือทำอย่างไรหรือไม่”
และเรื่องนี้ก็ไม่ได้เกิดขึ้นเฉพาะในซิลิคอนแวลลีย์ MaiAgent แพลตฟอร์ม AI Agent จากไต้หวัน เสนอแนวคิดที่แทบจะเหมือนกันทุกประการบนเวที VivaTech 2026 ว่า องค์กรไม่ได้ต้องการเครื่องมือ AI ที่แยกเป็นไซโลอีกชิ้น แต่ต้องการ “governed AI Core” ที่ให้ทีมใช้ข้อมูลที่ถูกต้องภายใต้สิทธิ์ที่ถูกต้องได้อย่างปลอดภัย ซึ่งก็คือข้อโต้แย้งเดียวกับบทความนี้ในอีกรูปแบบหนึ่ง
 คูเมืองย้ายจากลูกแก้วเรืองแสงตรงกลาง ไปสู่วงแหวนสีอำพันที่กว้างกว่ารอบนอก คูเมืองไม่ได้หายไป เพียงแต่ย้ายไปอยู่ในที่ที่โมเดลเอื้อมไม่ถึง
ความไว้วางใจกำลังกลายเป็นโจทย์การออกแบบผลิตภัณฑ์
เมื่อ Agent ลงมือทำงานได้จริง ธรรมชาติของปัญหาก็เปลี่ยนไปโดยสิ้นเชิง เมื่อก่อนถ้า AI ทำผิด ก็แค่ตอบผิดหนึ่งคำตอบ แต่เมื่อ Agent ทำผิด มันอาจส่งอีเมลผิด แก้ข้อมูลใน CRM ผิด สั่งของผิด หรือรันเวิร์กโฟลว์ทั้งชุดผิดพลาด
นี่คือเหตุผลที่เราเห็น Permission และ Governance เปลี่ยนจาก “เช็กลิสต์ด้านการปฏิบัติตามกฎที่ทำทีหลัง” มาเป็นชั้นผลิตภัณฑ์ในตัวเอง Meta Muse เป็นตัวอย่างที่ชัดเจน มันจงใจแยก “การดำเนินการ” และ “การอนุมัติ” ออกเป็น Agent สองตัวที่แยกขาดกันในระดับระบบ ตัว Muse ทำหน้าที่วางแผนและให้คำแนะนำ แต่หากไม่ได้รับอนุมัติจาก Agent อีกตัวที่ชื่อ Sentinel การกระทำผ่านเครือข่ายหรือการใช้งาน connector ใด ๆ ก็ไม่สามารถดำเนินการได้ ขั้นตอนที่อ่อนไหวจะถูกส่งกลับไปให้ผู้ใช้ยืนยันเสมอ และผู้ใช้สามารถดู audit trail ได้ครบถ้วน GPT-6 Astra ก็เดินในเส้นทางคล้ายกัน เนื่องจากความสามารถด้านไซเบอร์ซีเคียวริตี้ของมันแตะระดับ “Critical” ในกรอบความปลอดภัยของ OpenAI เป็นครั้งแรก OpenAI จึงยิ่งเพิ่มการเฝ้าติดตามพฤติกรรม หากระบบประเมินว่า Astra อาจเข้าใจคำสั่งผิด มันจะหยุดงานและรอให้ผู้ใช้ยืนยันก่อนดำเนินการต่อ
มีตัวเลขชุดหนึ่งที่ควรนำมาวางเทียบกันตรงนี้ องค์กรกว่า 60% กำลังทดลองใช้ AI Agent อยู่แล้ว แต่มีเพียง 20–30% เท่านั้นที่นำไปใช้งานในระดับสเกลในฟังก์ชันใดฟังก์ชันหนึ่ง ที่น่าสังเกตยิ่งกว่าคือ ผู้บริหารฝ่ายไอทีเพียงราว 10% กว่า ๆ เท่านั้นที่เชื่อว่าตนสามารถกำกับดูแล Agent ของตัวเองได้อย่างมีประสิทธิภาพ ช่องว่างนี้ไม่ได้อยู่ที่ความสามารถทางเทคนิค แต่อยู่ที่กลไกความไว้วางใจ
อินเทอร์เฟซของผลิตภัณฑ์ในอนาคตน่าจะไม่ใช่ตัวเลือกแบบขาวดำว่า “อนุญาตให้ AI / ไม่อนุญาตให้ AI” อีกต่อไป แต่จะมีสิทธิ์ที่ละเอียดกว่าเรียงเป็นแถว:
- อ่าน ✓
- วิเคราะห์ ✓
- ร่าง ✓
- อัปเดต CRM ✓
- ส่งออกภายนอก → ถามฉันก่อน
- ใช้จ่ายเงิน → ถามฉันก่อน
- ลบข้อมูล ✕
พูดอีกอย่างก็คือ Trust ในยุค Agent ไม่ได้เป็นแค่เรื่องความไว้วางใจต่อแบรนด์อีกต่อไป แต่ต้องถูกออกแบบฝังไว้ในสถาปัตยกรรมของผลิตภัณฑ์เลย
“โมเดลที่ดีที่สุด” อาจไม่ใช่คำตอบเลยก็ได้
Gemini 3.8 Flash ของ Google ที่เปิดตัวในสัปดาห์เดียวกัน เตือนสติผมจากอีกมุมหนึ่ง จุดยืนของมันไม่ใช่ “เราสร้างโมเดลที่ฉลาดที่สุด” แต่วางตัวเป็นม้างานต้นทุนต่ำประสิทธิภาพสูง ตั้งราคาไว้ที่ US$0.75 ต่อหนึ่งล้านอินพุตโทเค็น และ US$3.75 ต่อหนึ่งล้านเอาต์พุตโทเค็น Google ถึงขั้นแนะนำอย่างเปิดเผยว่า งานบางประเภทใช้โมเดลรุ่นเก่าต่อไปก็ได้ ไม่จำเป็นต้องอัปเกรดทุกครั้ง
เรื่องนี้สำคัญเป็นพิเศษสำหรับ Agent แชตบอตอาจจบงานได้ด้วยการประมวลผลเพียงรอบเดียว แต่การจะทำงานหนึ่งชิ้นให้สำเร็จ Agent มักต้องคิด ค้นหา คิดอีก อ่าน คิดอีก ใช้เครื่องมือ ตรวจสอบ ลองใหม่ สร้างผลลัพธ์ และยืนยันความถูกต้อง ซึ่งต้องประมวลผลหลายสิบหรือแม้แต่หลายร้อยครั้ง ถึงจุดนั้นคำถามจึงไม่ใช่ “โมเดลไหนฉลาดที่สุด” อีกต่อไป แต่เป็น “สำหรับขั้นตอนนี้ โมเดลไหนถูกที่สุดโดยที่ยังเชื่อถือได้เพียงพอ” ระบบประมวลผลแบบผสมระหว่างอุปกรณ์และคลาวด์ที่ Perplexity เพิ่งนำเสนอก็ใช้ตรรกะเดียวกัน ข้อมูลที่อ่อนไหวอยู่บนอุปกรณ์ และจะส่งงานขึ้นคลาวด์ก็ต่อเมื่อต้องการความสามารถที่สูงกว่าจริง ๆ เท่านั้น
ผมจึงเชื่อว่าความได้เปรียบในการแข่งขันหลักของผลิตภัณฑ์กำลังค่อย ๆ ย้ายจาก “เราใช้โมเดลของบริษัทไหน” ไปสู่ “เราเลือกความฉลาดที่เหมาะสมให้แต่ละงานอย่างไร” นั่นคือ Model Orchestration พูดง่าย ๆ คือการเลือกชุดโมเดลที่เหมาะสมและคุ้มค่าที่สุดแบบไดนามิกตามลักษณะของแต่ละงาน แทนที่จะโยนทุกขั้นตอนให้ “โมเดลที่เก่งที่สุด” ตัวเดียว และแท้จริงแล้วมันก็เป็นอีกด้านหนึ่งของเรื่องเดียวกันกับ Context และ Trust ที่กล่าวไปข้างต้น: คุณต้องเข้าใจงานและกฎของบริษัทก่อน จึงจะตัดสินใจได้ว่างานไหนควรใช้โมเดลไหน และการกระทำไหนต้องการสิทธิ์ระดับใด
กลับมาที่ OakMega: Context, Action และ Trust ครบในที่เดียว
หลังจากเฝ้าดูความเคลื่อนไหวในช่วงไม่กี่สัปดาห์นี้ ผมกลับยิ่งมั่นใจในเส้นทางที่ OakMega จะเดินต่อไป
ส่วนแรกคือบทบาทของ Social CRM เราได้ทำให้ “การทำความเข้าใจและบริหารความสัมพันธ์กับลูกค้า” กลายเป็นผลิตภัณฑ์ แบรนด์ลูกค้าที่มีขนาดถึงระดับหนึ่งและมีโครงสร้างข้อมูลค่อนข้างเป็นมาตรฐาน จึงสามารถได้รับความสามารถของ Context Layer นี้โดยตรงผ่าน Social CRM นี่คือเส้นทางสู่การขยายสเกล เดิมที Social CRM คือ “เครื่องมือบริหารความสัมพันธ์กับลูกค้า” แต่ต่อจากนี้ มันจะใกล้เคียงกับ “Context Layer ที่ช่วยให้ AI เข้าใจและบริหารความสัมพันธ์กับลูกค้าได้” มากขึ้น
ส่วนที่สองคือบทบาทของ FDE (Forward Deployed Engineering) ความจริงก็คือ โครงสร้างข้อมูล ตรรกะทางธุรกิจ และกฎการให้สิทธิ์ของแต่ละบริษัทล้วนแตกต่างกัน ไม่มีผลิตภัณฑ์สำเร็จรูปใดที่เหมาะกับทุกสถานการณ์ และนั่นคือเหตุผลที่ FDE มีอยู่ เมื่อบริษัทไม่ได้ต้องการ “ซื้อฟีเจอร์” แต่ต้องการ “เปลี่ยนตรรกะความสัมพันธ์กับลูกค้าที่เป็นเอกลักษณ์ของเราให้กลายเป็นระบบที่ Agent ทำงานได้อย่างปลอดภัย” วิศวกรของเราจะลงไปฝังตัวอยู่ในข้อมูลและกระบวนการของลูกค้า และสร้างกฎทั้งสามชั้น ได้แก่ Context, Action และ Trust ทีละบริษัท รูปแบบที่ผ่านการพิสูจน์แล้วในโปรเจกต์ FDE จะถูกส่งกลับเข้าสู่ผลิตภัณฑ์ Social CRM ในท้ายที่สุด เพื่อให้ลูกค้ากลุ่มถัดไปได้รับประโยชน์โดยตรง
ไม่ว่าบริษัทจะอยู่ในระยะไหน จะมีความต้องการที่เป็นมาตรฐานแล้ว หรือยังต้องการการติดตั้งแบบปรับแต่งเฉพาะ ผมเชื่อว่าสิ่งที่ OakMega มอบให้คือสองรูปแบบของสิ่งเดียวกัน: ทำให้ AI เข้าใจความสัมพันธ์กับลูกค้าของคุณอย่างแท้จริง และไว้วางใจให้มันบริหารความสัมพันธ์เหล่านั้นได้
Claudeforce ของ Salesforce ทำให้เห็นชัดแล้วว่า ตัวโมเดล AI ไม่ใช่คูเมืองของ CRM แต่บริบทของลูกค้า ตรรกะทางธุรกิจ สิทธิ์ และการกระทำที่อยู่ภายใน CRM ต่างหากที่ใช่ เมื่อความฉลาดของโมเดลยังคงกลายเป็นสินค้าโภคภัณฑ์ต่อไป ผมเชื่อว่านี่คือสิ่งที่ OakMega จะทุ่มเทสร้างมากที่สุดนับจากนี้ ไม่ว่าจะเป็นการสร้างในระดับสเกลผ่าน Social CRM หรือการปรับแต่งทีละบริษัทผ่าน FDE
FAQ
Q1: มีฉันทามติจริงหรือไม่ว่าโมเดลจะกลายเป็นสินค้าโภคภัณฑ์?
ความเห็นในอุตสาหกรรมชี้ไปในทิศทางที่ค่อนข้างสอดคล้องกัน รวมถึงการถกเถียงว่าโมเดลกำลัง “คล้ายสินค้าโภคภัณฑ์มากขึ้นเรื่อย ๆ” ผู้สังเกตการณ์ส่วนใหญ่มองว่าความแตกต่างด้านความฉลาดของตัวโมเดลกำลังลดลง และความได้เปรียบที่ยั่งยืนจะย้ายไปอยู่ที่สินทรัพย์ “รอบตัวโมเดล” เช่น connectors ข้อมูล และกฎการกำกับดูแล อย่างไรก็ตาม นี่เป็นการประเมินแนวโน้ม ไม่ใช่ข้อสรุปที่ตายตัว และยังควรติดตามต่อไป
Q2: ปัจจุบันองค์กรมักติดขัดตรงไหนเมื่อนำ AI Agent มาใช้?
จากข้อสังเกตในอุตสาหกรรมที่มีอยู่จนถึงตอนนี้ องค์กรส่วนใหญ่ไม่ได้ติดขัดเพราะ “โมเดลไม่ฉลาดพอ” แต่ติดขัดที่กลไกการกำกับดูแลและความไว้วางใจ ไม่แน่ใจว่าควรให้สิทธิ์ Agent มากแค่ไหน ใครต้องรับผิดชอบเมื่อเกิดข้อผิดพลาด และจะติดตามได้อย่างไรว่ามันทำอะไรไปบ้าง นี่คือเหตุผลที่ Permission/Governance กำลังกลายเป็นโจทย์การออกแบบผลิตภัณฑ์ในตัวเอง
Q3: องค์กรควรเลือกระหว่าง Social CRM และบริการ FDE ของ OakMega อย่างไร?
พูดง่าย ๆ ถ้าโครงสร้างข้อมูลและกระบวนการของบริษัทค่อนข้างเป็นมาตรฐานแล้ว Social CRM สามารถมอบความสามารถของ Context Layer ได้โดยตรง แต่ถ้าบริษัทมีตรรกะทางธุรกิจ การเชื่อมต่อระบบ หรือกฎการกำกับดูแลเฉพาะที่ต้องติดตั้งแบบปรับแต่ง FDE จะเป็นจุดเริ่มต้นที่เหมาะสมกว่า นอกจากนี้ยังสามารถพิสูจน์แนวทางด้วย FDE ก่อน แล้วค่อย ๆ นำ Social CRM มาใช้ได้
Q4: Context Layer คืออะไร?
Context Layer คือชั้นข้อมูลและกฎที่ช่วยให้ AI Agent เข้าใจความสัมพันธ์กับลูกค้า ตรรกะทางธุรกิจ และกฎการกำกับดูแลอันเป็นเอกลักษณ์ของแต่ละบริษัท มันไม่ใช่ตัวโมเดล แต่เป็นชั้นที่อยู่นอกโมเดลซึ่งบอก Agent ว่า “ควรลงมือทำอย่างไร” และเป็นจุดที่บทความนี้มองว่าคือคูเมืองแห่งถัดไป
References
- OpenAI, GPT-6 Astra: A new generation of intelligence
- Fortune, OpenAI launches GPT-6 Astra
- CSO Online, OpenAI launches GPT-6 Astra, its first model to cross a critical cybersecurity threshold
- Salesforce, Salesforce and Anthropic Announce Claudeforce
- Anthropic, Introducing Claude Fable 5.1 and Claude Mythos 5.1
- Enterprise DNA, SpaceXAI Launches Grok 4.6 for Enterprise Agents
- Reworked, xAI Wants In on the Enterprise With Grok Bot
- about.fb.com (Meta), Introducing Muse: The World's First Personal AI Agent
- Help Net Security, Google's Gemini 3.8 Flash takes on bigger AI models at a lower cost
- VentureBeat, Perplexity AI unveils hybrid local-cloud inference system at Computex 2026
- Seeking Alpha, AI's Next Moat: What Survives When Models Become Commodities
- Accelirate, Agentic AI Statistics 2026
- CXO XPERTS, AI Agent Governance: Why It's Enterprise AI's Biggest Challenge in 2026
- CNBC, McDonald's to end AI drive-thru test with IBM
- Al Jazeera, McDonald's scraps AI pilot after order mix-ups go viral
- Restaurant Dive, McDonald's ends IBM drive-thru voice order test
- Restaurant Business, McDonald's is ending its drive-thru AI test
- TikTok (@tech360.tv), McDonald's withdraws AI technology after bacon ice cream and nugget overload orders
- PR Newswire, At VivaTech 2026, Taiwan-Based MaiAgent Says Enterprises Should Stop Building RAG and AI Agent Systems From Scratch