NVIDIA ra mắt nền tảng Vera Rubin: Điện toán AI chính thức bước vào kỷ nguyên “tái cấu trúc cấp hệ thống” | CEO Insights
Nền tảng Vera Rubin được NVIDIA công bố tại CES giúp giảm chi phí inference token xuống còn 1/10, đẩy nhanh hành trình trở thành Agentic Enterprise của doanh nghiệp.
 Porsche TsaiCEO
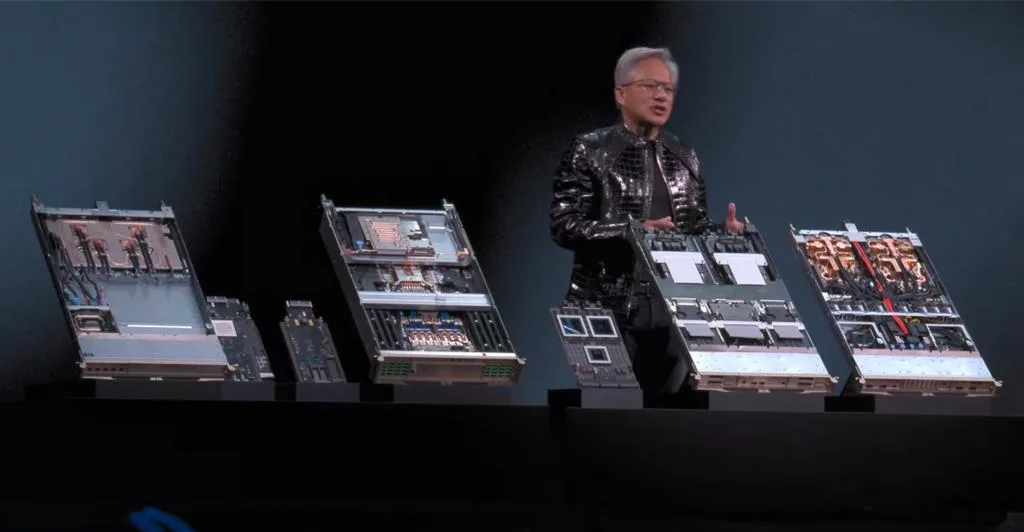
Trong nhịp phát triển chóng mặt của điện toán AI, các thế hệ nền tảng phần cứng thường thay thế nhau theo chu kỳ năm. Thế nhưng, chưa đầy một năm sau khi ra mắt kiến trúc Blackwell, Jensen Huang đã lên sân khấu CES để công bố nền tảng điện toán AI thế hệ tiếp theo của NVIDIA: Vera Rubin. Điều này cho thấy cốt lõi của cuộc đua không còn chỉ là nâng cao hiệu năng của một con chip, mà là định nghĩa lại toàn bộ kiến trúc điện toán AI.
Vera Rubin không ra đời chỉ để theo đuổi hiệu năng đỉnh cao hơn, mà để giải quyết một vấn đề thực tế hơn: khi mô hình AI liên tục phình to, quy trình suy luận ngày càng dài và phức tạp, cách thiết kế truyền thống lấy GPU làm trung tâm và chủ yếu xếp chồng các mô-đun đang dần trở thành điểm nghẽn về cả hiệu năng lẫn chi phí.
Mang tên một nhà thiên văn học, ẩn dụ cho bước chuyển cấp hệ thống
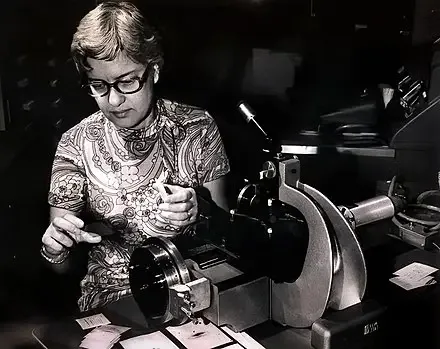
Vera Rubin là nhà thiên văn học nổi tiếng với việc chứng minh sự tồn tại của vật chất tối. Nghiên cứu của bà đã hé lộ một sự thật then chốt: thứ thực sự chi phối chuyển động của các thiên hà không phải là vật chất mắt thường nhìn thấy, mà là cấu trúc vô hình phía sau, thứ quyết định mọi thứ.
Việc NVIDIA đặt cái tên này cho nền tảng AI thế hệ mới tượng trưng cho sự chuyển hướng công nghệ: chìa khóa của AI không còn chỉ nằm ở bản thân mô hình, mà ở cấu trúc hệ thống vô hình giúp mô hình vận hành. Nền tảng Vera Rubin chính là nỗ lực xây dựng lại nền móng của điện toán AI ở tầng này.
Extreme Co-Design: Từ thiết kế chip đến kỹ thuật hệ thống
Vera Rubin không phải một bộ xử lý đơn lẻ, mà là một nền tảng hoàn chỉnh được xây dựng theo tư duy extreme co-design. Ngay từ đầu, NVIDIA đã đồng thời tính đến sự phối hợp giữa sáu con chip chủ chốt, hợp nhất điện toán, phân cấp bộ nhớ, kết nối nội bộ, mạng và hiệu năng cấp hệ thống thành một mục tiêu thiết kế duy nhất.
Cách làm này khác hẳn mô hình cũ “thiết kế linh kiện trước, tích hợp hệ thống sau”. Cốt lõi của Vera Rubin là bảo đảm dữ liệu lưu chuyển trong toàn hệ thống theo đường ngắn nhất, với độ trễ và mức tiêu thụ năng lượng thấp nhất, từ đó rút ngắn đáng kể thời gian huấn luyện và chi phí suy luận. Chính kiểu tối ưu cấp hệ thống này là chìa khóa tạo nên bước nhảy vọt hiệu năng giữa các thế hệ.
Không dây cáp, không lỗ thông, không quạt: Thiết kế vật lý sinh ra cho suy luận AI
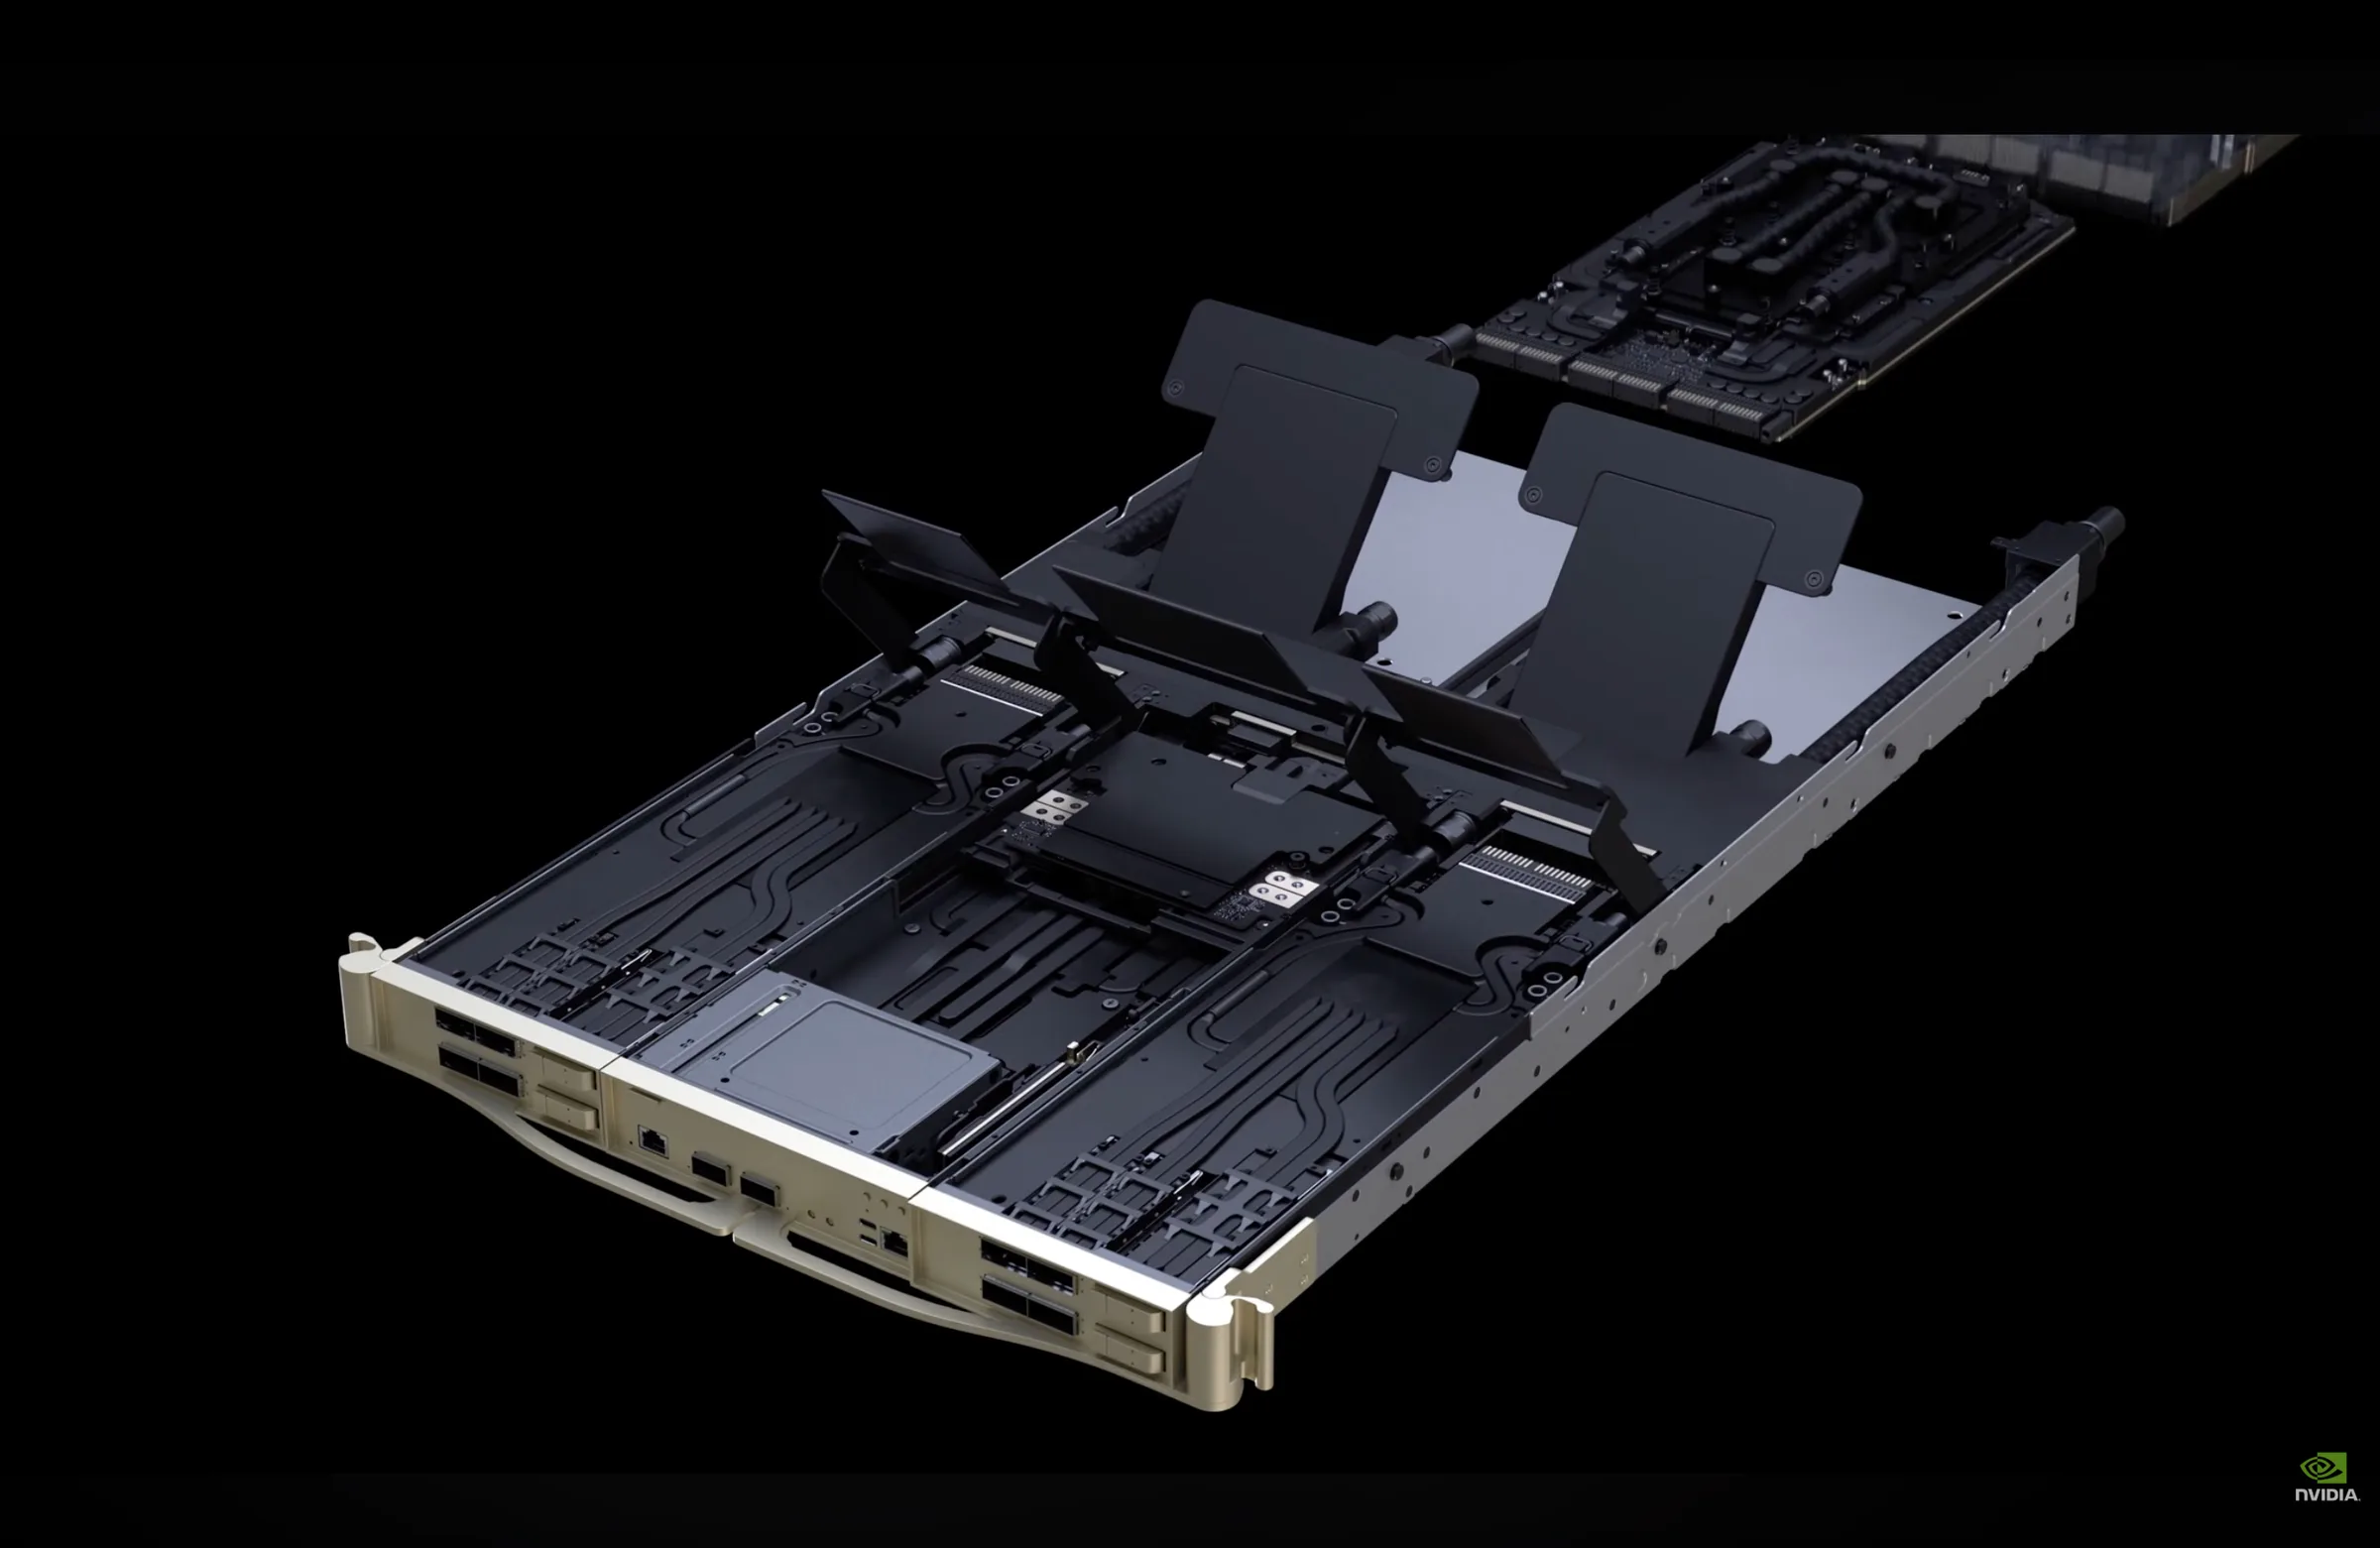
Tư duy hệ thống này cũng được thể hiện cụ thể trong thiết kế Compute Tray của Vera Rubin. Để tối đa hóa hiệu suất truyền tải và giảm tiêu thụ năng lượng, NVIDIA sử dụng cấu trúc không dây cáp, không lỗ thông, không quạt, tích hợp việc truyền tải điện và dữ liệu vào backplane và các giao diện tiếp xúc trực tiếp.
Thiết kế này không chỉ giảm trở kháng và rủi ro hỏng hóc do dây cáp gây ra, mà còn cho phép tối ưu tản nhiệt và quản lý năng lượng ở cấp rack. Với các tác vụ suy luận AI và khối lượng công việc dạng agent cần vận hành liên tục trong thời gian dài và rất nhạy cảm với độ trễ, hành vi hệ thống ổn định, có thể dự đoán như vậy mang giá trị thực tế lớn hơn hiệu năng đơn điểm.
Khi một Rack trở thành bộ xử lý AI logic
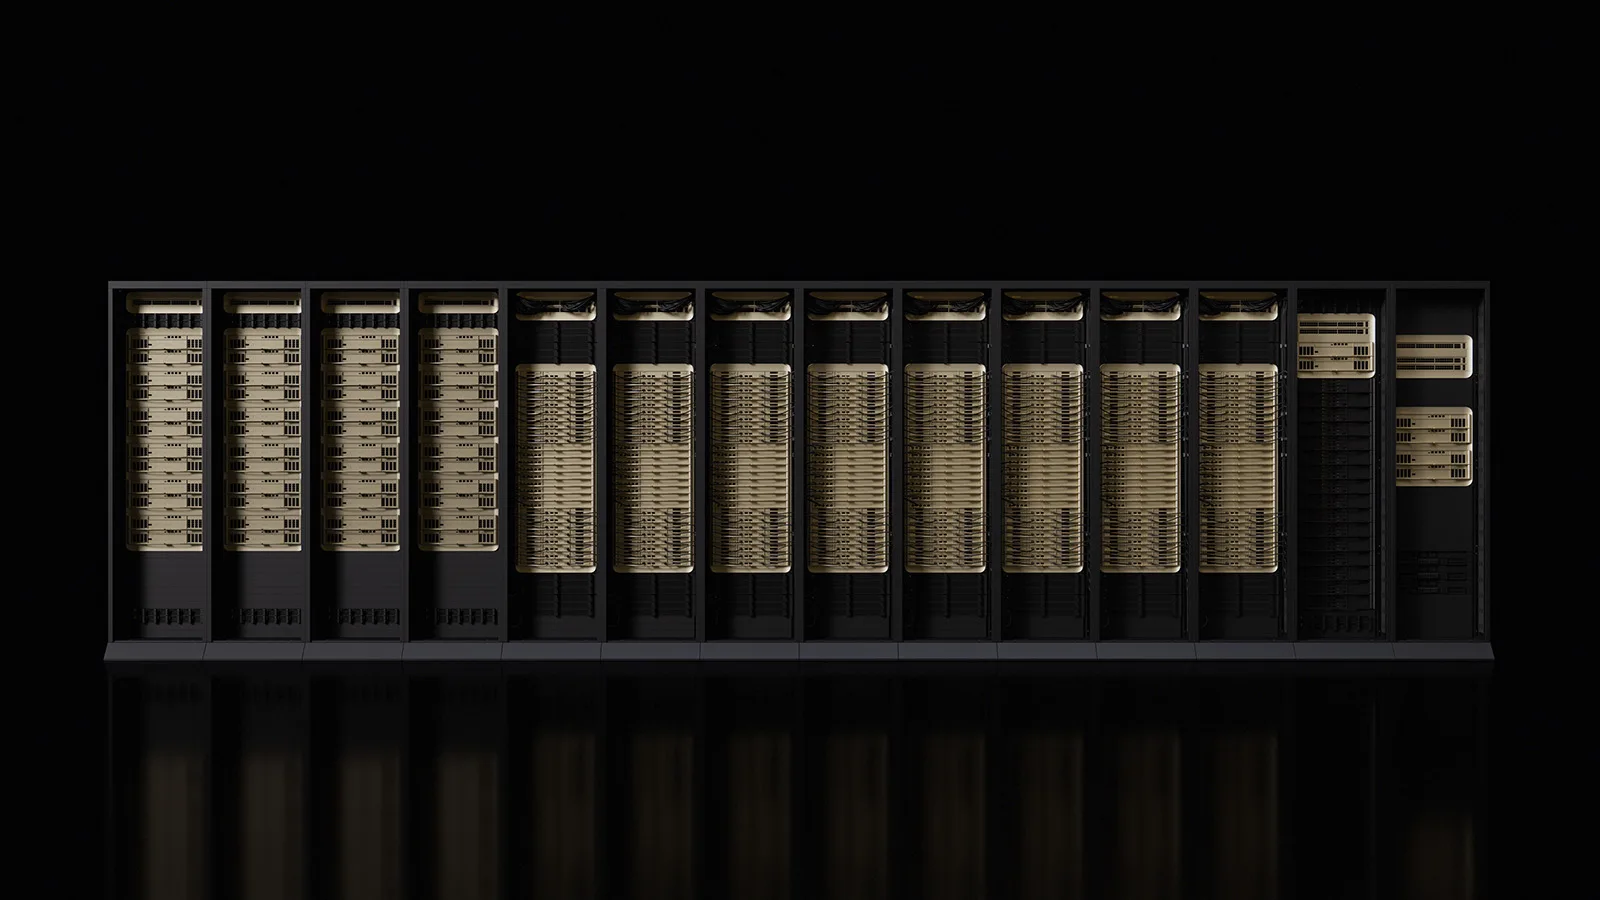
Về quy mô, Vera Rubin càng thể hiện rõ định vị cấp hệ thống. Một rack gồm 18 Vera Rubin Trays, với tổng cộng hơn 220 nghìn tỷ bóng bán dẫn. Mức độ phức tạp này đã vượt xa khả năng của một con chip hay một máy chủ đơn lẻ.
Ở cấp độ này, đơn vị thiết kế không còn là GPU mà là cả tủ máy. Truyền dữ liệu, đồng bộ, kiểm soát độ trễ và độ tin cậy đều phải được cân nhắc tổng thể ở cấp hệ thống. Triết lý thiết kế của Vera Rubin chính là coi cả rack như một siêu bộ xử lý AI logic duy nhất.
Sinh ra cho suy luận: Đáp ứng nhu cầu của mô hình lớn và mô hình suy luận
Vera Rubin hướng đến một thay đổi mang tính cấu trúc trong hướng phát triển của AI. Khi quy mô mô hình tiếp tục mở rộng, đặc biệt với sự trỗi dậy của các mô hình suy luận (reasoning models), AI không còn chỉ tạo ra kết quả trong một lần, mà cần tiêu tốn lượng lớn token để suy luận nhiều bước, chuỗi dài nhằm đưa ra câu trả lời chính xác hơn.
Điểm nghẽn của những khối lượng công việc này thường không nằm ở hiệu năng đỉnh, mà ở việc chi phí suy luận có kiểm soát được hay không và hệ thống có vận hành ổn định trong thời gian dài hay không. Mục tiêu của Vera Rubin chính là biến kiểu suy luận này thành hiện thực có thể triển khai ở quy mô lớn.
Từ ứng dụng cá nhân đến Agentic Enterprise
Điều này cũng lý giải vì sao đối tượng thực sự của Vera Rubin là doanh nghiệp, chứ không chỉ là các tình huống sử dụng cá nhân. Khi AI bắt đầu đi vào quy trình cốt lõi của doanh nghiệp, nó phải truy cập dữ liệu nội bộ một cách an toàn, tuân theo quy trình làm việc sẵn có, và tự động thực hiện hành động sau khi hiểu và suy luận, trở thành một phần trong hoạt động vận hành của doanh nghiệp.
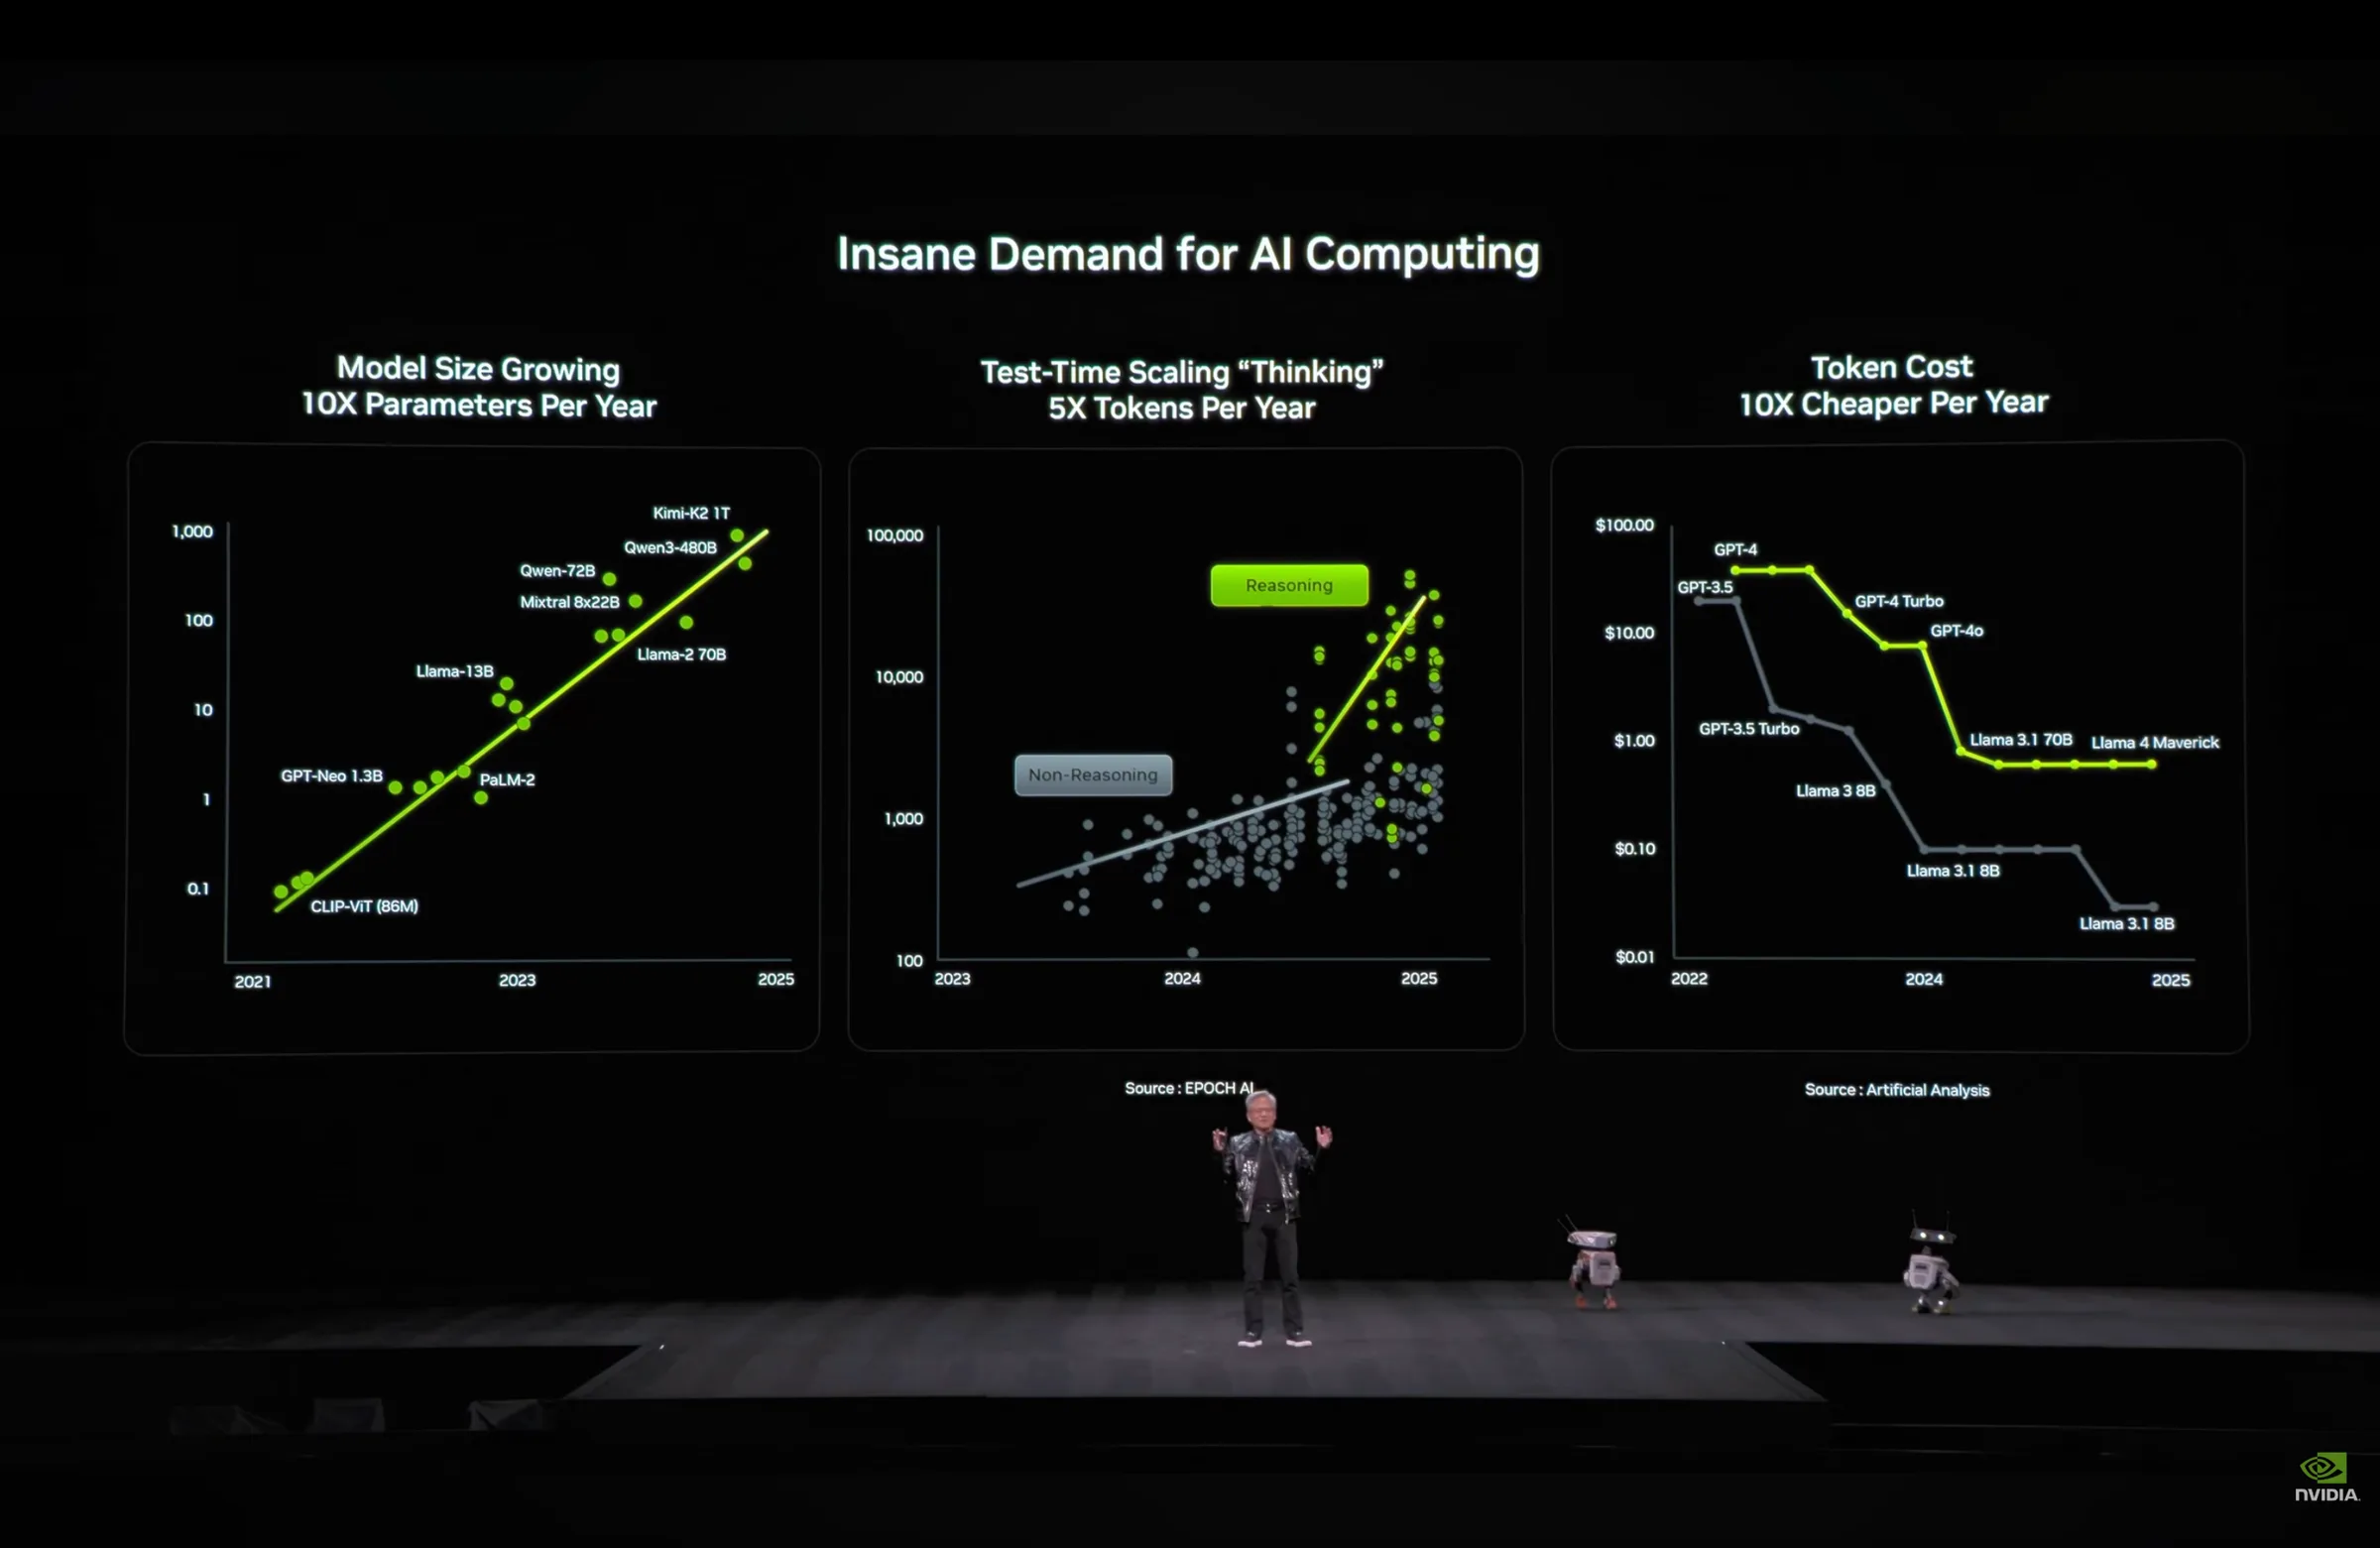
Trong bối cảnh “Agentic Enterprise” như vậy, việc giảm chi phí suy luận mang ý nghĩa quyết định. Vera Rubin mang lại chi phí cho mỗi inference token chỉ còn một phần mười so với thế hệ trước, giúp doanh nghiệp chuyển nguồn lực từ đầu tư năng lực tính toán nền tảng sang các ứng dụng AI và thiết kế quy trình thực sự tạo ra giá trị.
Khi nền tảng được định nghĩa lại, khả năng của AI cũng được viết lại
Ý nghĩa của Vera Rubin không chỉ là một con số hiệu năng tăng lên, mà là lời tuyên bố rằng điện toán AI đã bước sang một giai đoạn mới. Khi đơn vị tính toán mở rộng từ chip sang hệ thống, từ máy chủ sang rack, vai trò mà AI có thể đảm nhận cũng thay đổi theo.
Theo bạn, chính nhu cầu của doanh nghiệp về một AI thông minh và tự chủ hơn đã thúc đẩy nền tảng này ra đời? Hay sự xuất hiện của nền tảng đã mở ra một hình dung hoàn toàn mới của doanh nghiệp về AI? Hãy để lại bình luận cho tôi biết nhé.