NVIDIA Vera Rubin プラットフォーム登場:AI コンピューティングは「システムレベルの再構築」の時代へ | CEO Insights
NVIDIA が CES で発表した Vera Rubin プラットフォームは、inference token のコストを10分の1に引き下げ、企業の Agentic Enterprise への移行を加速させます。
 Porsche TsaiCEO
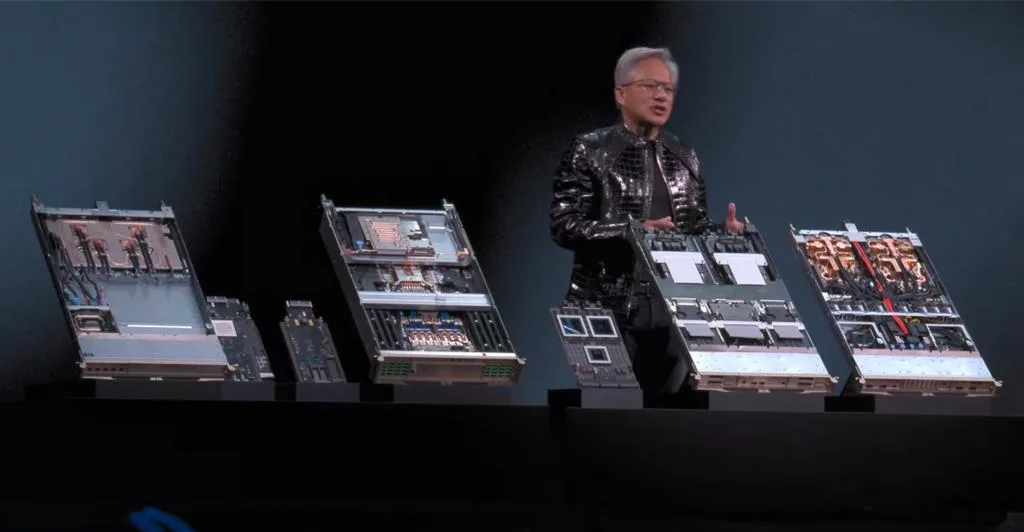
AI コンピューティングが急速に進化するなか、ハードウェアプラットフォームの世代交代は通常、年単位で進みます。ところが、NVIDIA は Blackwell アーキテクチャの投入から1年も経たないうちに、ジェンスン・フアン氏が CES で次世代の AI コンピューティングプラットフォーム「Vera Rubin」を発表しました。この競争の核心が、もはや単一チップの性能向上ではなく、AI コンピューティングのアーキテクチャ全体の再定義へと移ったことを示しています。
Vera Rubin は、単にピーク性能の向上を追い求めるために生まれたのではありません。より現実的な課題への答えです。AI モデルが巨大化を続け、推論プロセスがより長く複雑になるにつれ、GPU を中心にモジュールを積み上げる従来の設計手法は、性能とコストの両面で制約になりつつあります。
天文学者の名に込められた、システムレベルの転換
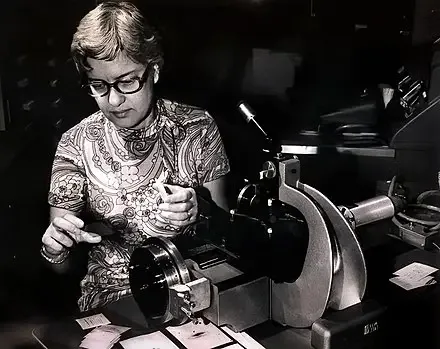
ヴェラ・ルービンは、暗黒物質の存在を実証したことで知られる天文学者です。彼女の研究は重要な事実を明らかにしました。宇宙で銀河の運動を本当に支配しているのは、目に見える物質ではなく、その背後にある目に見えない、しかしすべてを左右する構造だということです。
NVIDIA がこの名前を新世代の AI プラットフォームに冠したことは、技術の方向性の転換を象徴しています。AI のカギはもはやモデルそのものだけにあるのではなく、モデルの稼働を支える目に見えないシステム構造にあるのです。Vera Rubin プラットフォームは、まさにこのレイヤーで AI コンピューティングの基盤を築き直そうとしています。
Extreme Co-Design:チップ設計からシステムエンジニアリングへ
Vera Rubin は単一のプロセッサではなく、extreme co-design の発想でつくられた完全なプラットフォームです。NVIDIA は設計の初期段階から6つの主要チップの連携を同時に考慮し、演算、メモリ階層、インターコネクト、ネットワーク、そしてシステムレベルの性能を、ひとつの設計目標として統合しました。
これは「先にコンポーネントを設計し、後からシステムを統合する」という従来のやり方とはまったく異なります。Vera Rubin の核心は、データがシステム全体を最短経路・最低遅延・最小エネルギーで流れるようにすることで、学習時間と推論コストを大幅に削減する点にあります。こうしたシステムレベルの最適化こそが、世代を超える性能の飛躍を可能にしているのです。
ケーブルなし、開口部なし、ファンなし:AI 推論のための物理設計
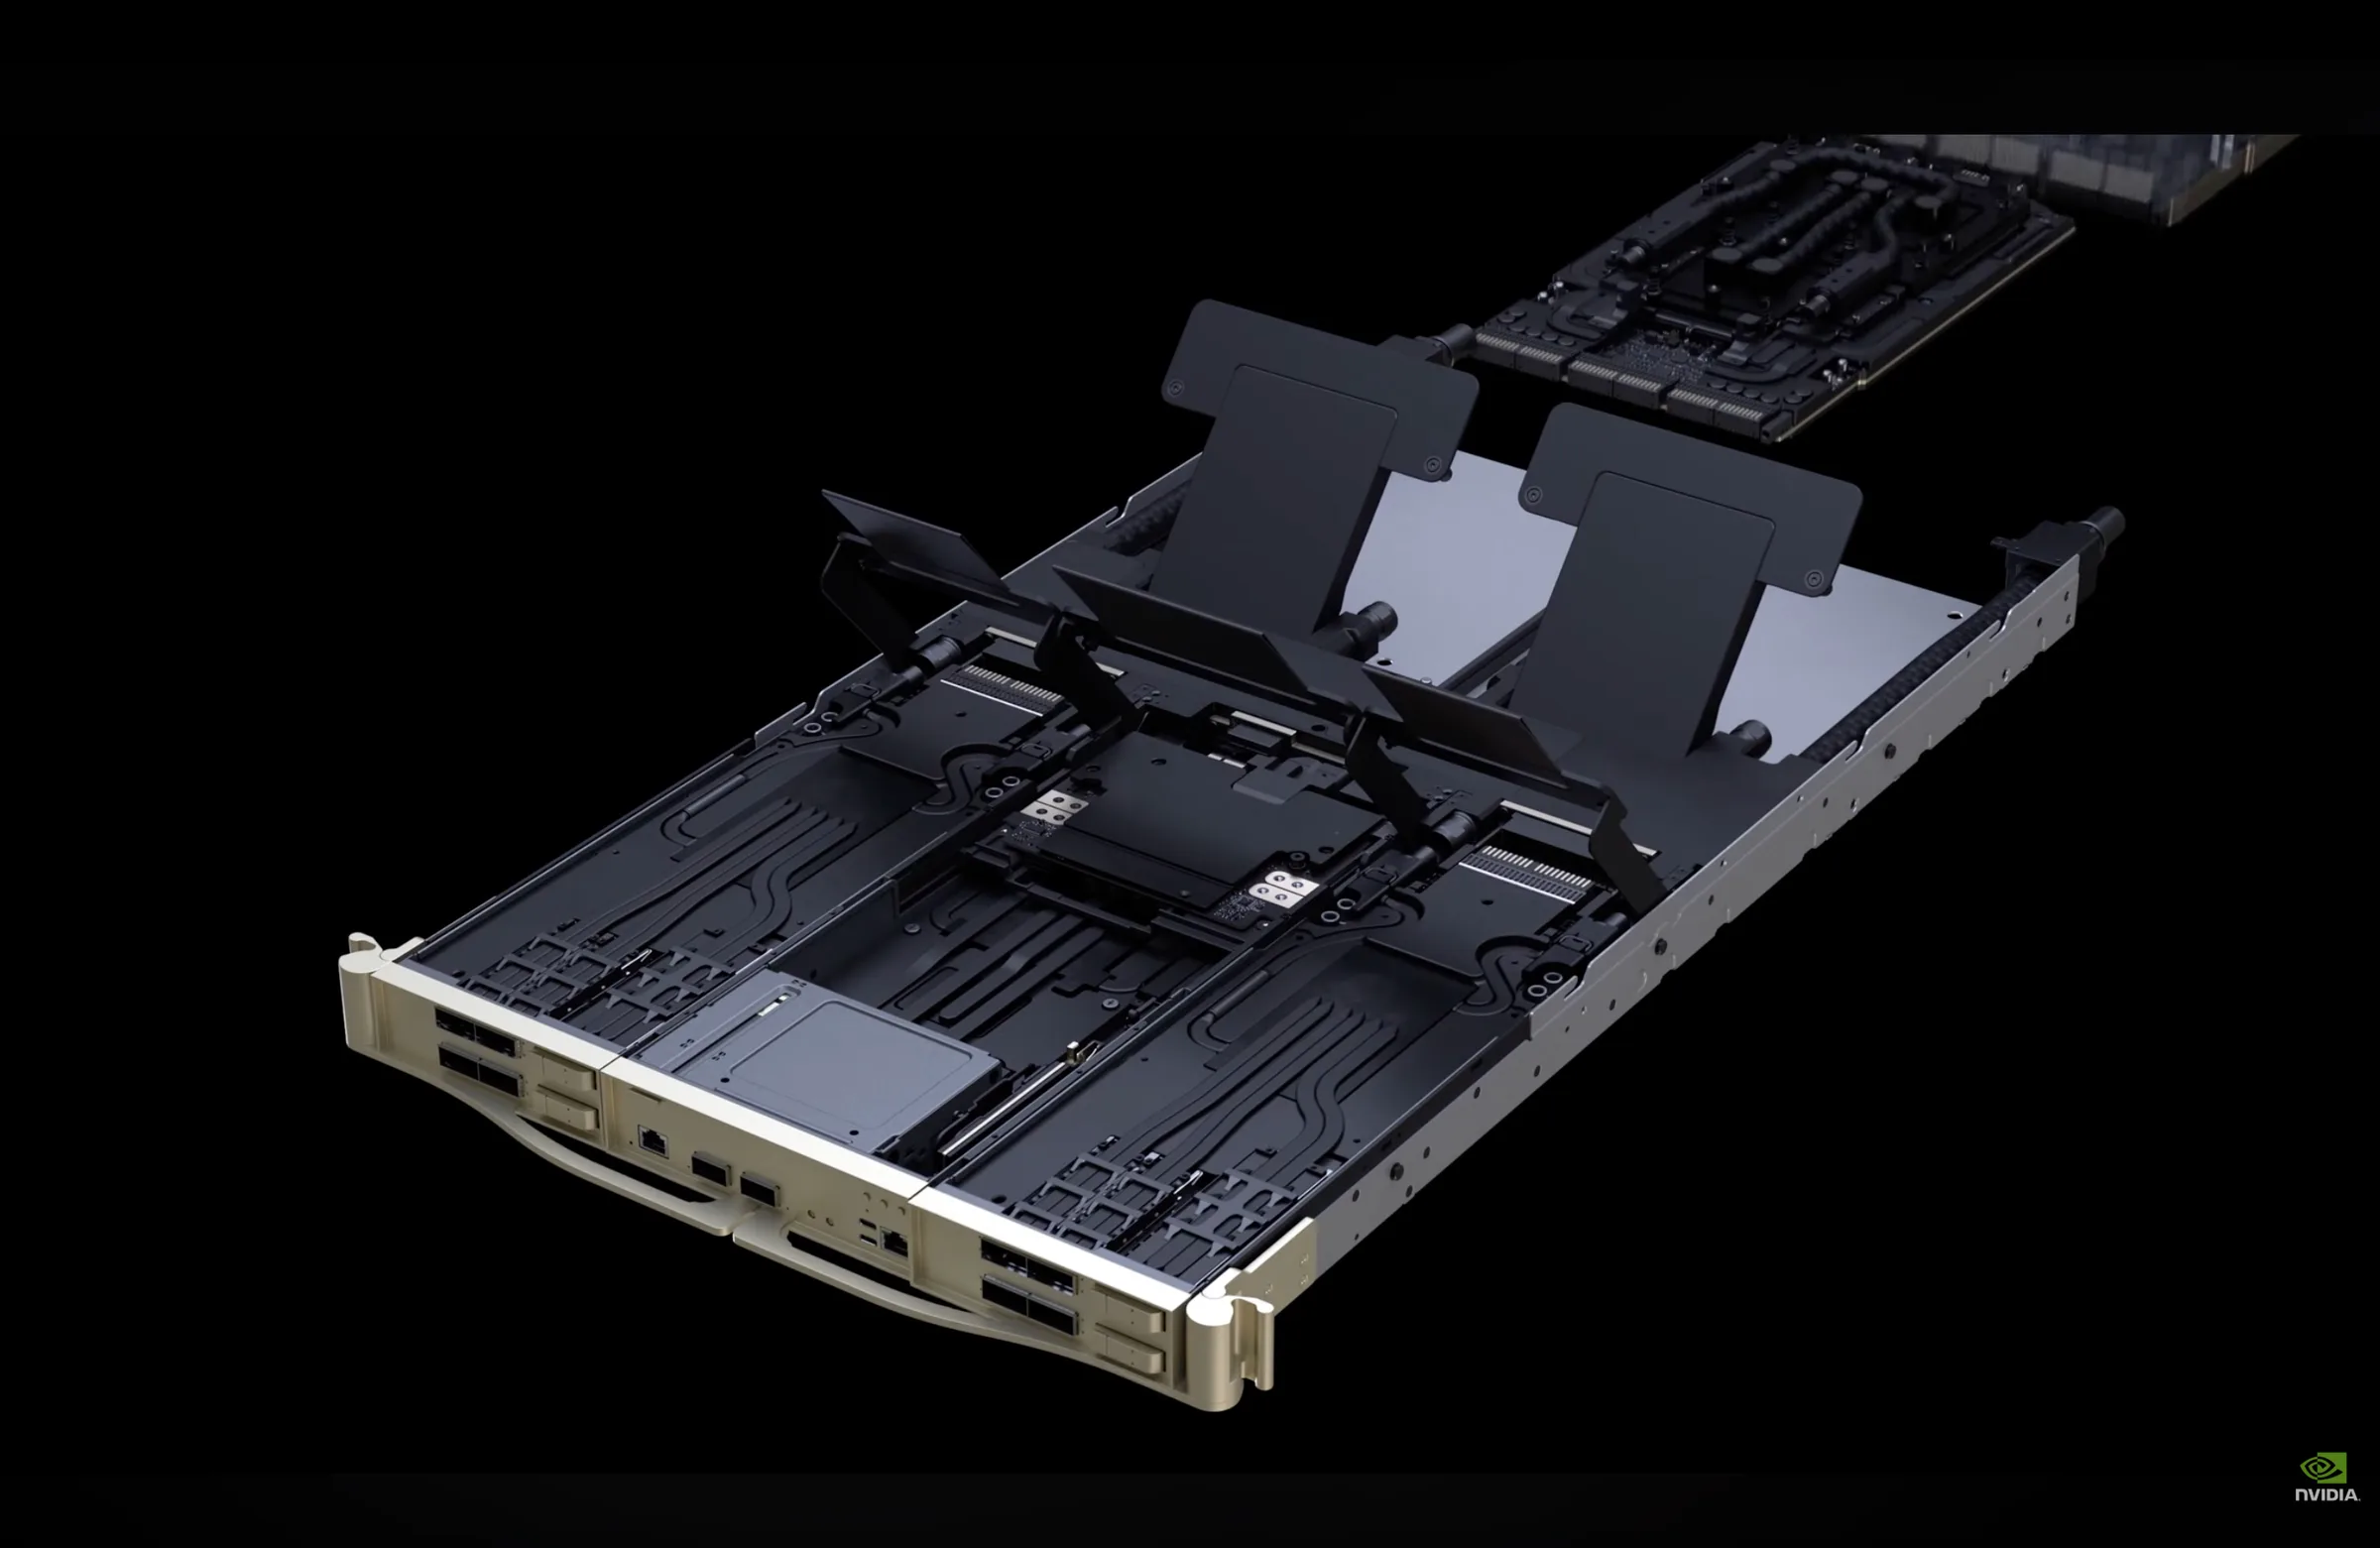
このシステム思考は、Vera Rubin の Compute Tray の設計にも具体的に表れています。伝送効率を最大化し消費電力を抑えるため、NVIDIA はケーブルなし、開口部なし、ファンなしの構造を採用し、電力とデータの伝送を backplane と直接接触インターフェースに統合しました。
この設計により、ケーブルに起因するインピーダンスや故障のリスクが減るだけでなく、冷却と電力管理を rack 単位で最適化できるようになります。長時間稼働し、遅延に非常に敏感な AI 推論やエージェント型のワークロードにとっては、単体の性能よりも、こうした安定的で予測可能なシステムの挙動のほうが実際の価値は大きいのです。
1台の Rack が論理的な AI プロセッサになるとき
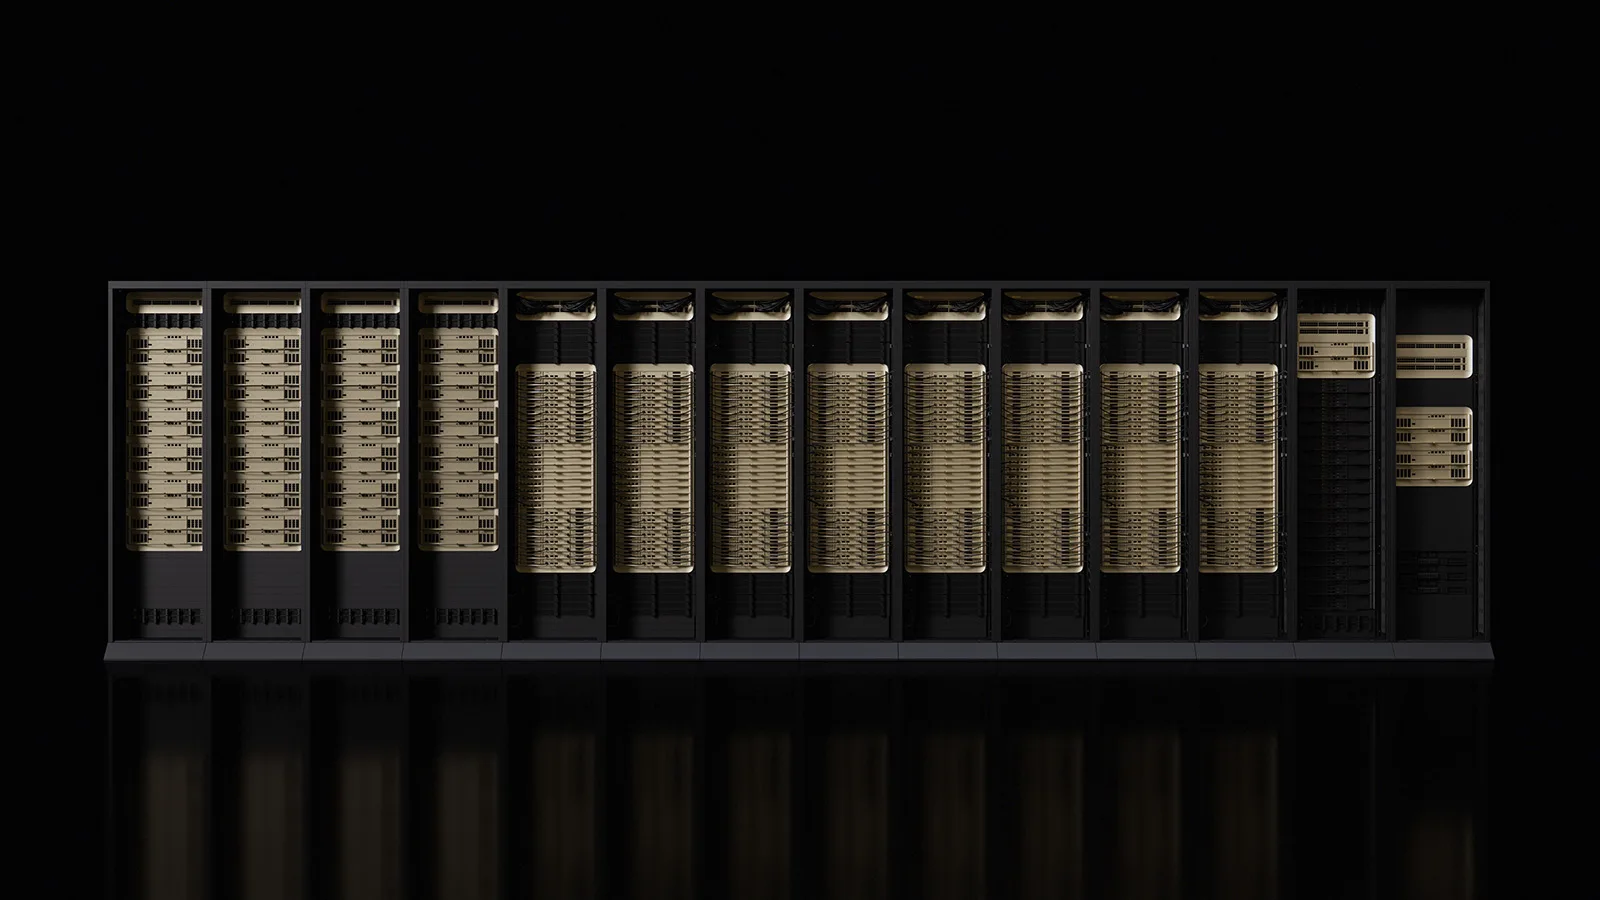
規模の面でも、Vera Rubin のシステムレベルの位置づけはより鮮明です。1台の rack は18基の Vera Rubin Trays で構成され、トランジスタの総数は 220兆個 を超えます。この規模は、単一のチップやサーバーで扱える複雑さをはるかに超えています。
このレベルになると、設計の単位はもはや GPU ではなく、ラック全体です。データ転送、同期、遅延制御、信頼性は、システムレベルで総合的に検討しなければなりません。Vera Rubin の設計思想は、まさに rack 全体をひとつの論理的な AI スーパープロセッサとして捉えることにあります。
推論のために生まれた:大規模モデルと推論型モデルの需要に応える
Vera Rubin が見据えているのは、AI の発展方向における構造的な変化です。モデルの規模が拡大を続け、とりわけ推論型モデル(reasoning models)が台頭するなか、AI は一度で結果を生成するだけではなくなりました。より正確な答えを得るために、大量の token を消費し、多段階で長いシーケンスの推論を行う必要があります。
こうしたワークロードのボトルネックは、ピーク性能ではなく、推論コストを制御できるか、システムが長時間安定して稼働できるかにあることが少なくありません。Vera Rubin の目標は、こうした推論を大規模に展開できる現実のものにすることです。
個人の利用から Agentic Enterprise へ
これは、Vera Rubin の本当のターゲットが個人の利用シーンではなく企業である理由でもあります。AI が企業の中核業務に入り込むには、社内データに安全にアクセスし、既存のワークフローに沿って動き、理解と推論のうえで自動的にアクションを実行し、企業運営の一部となる必要があります。
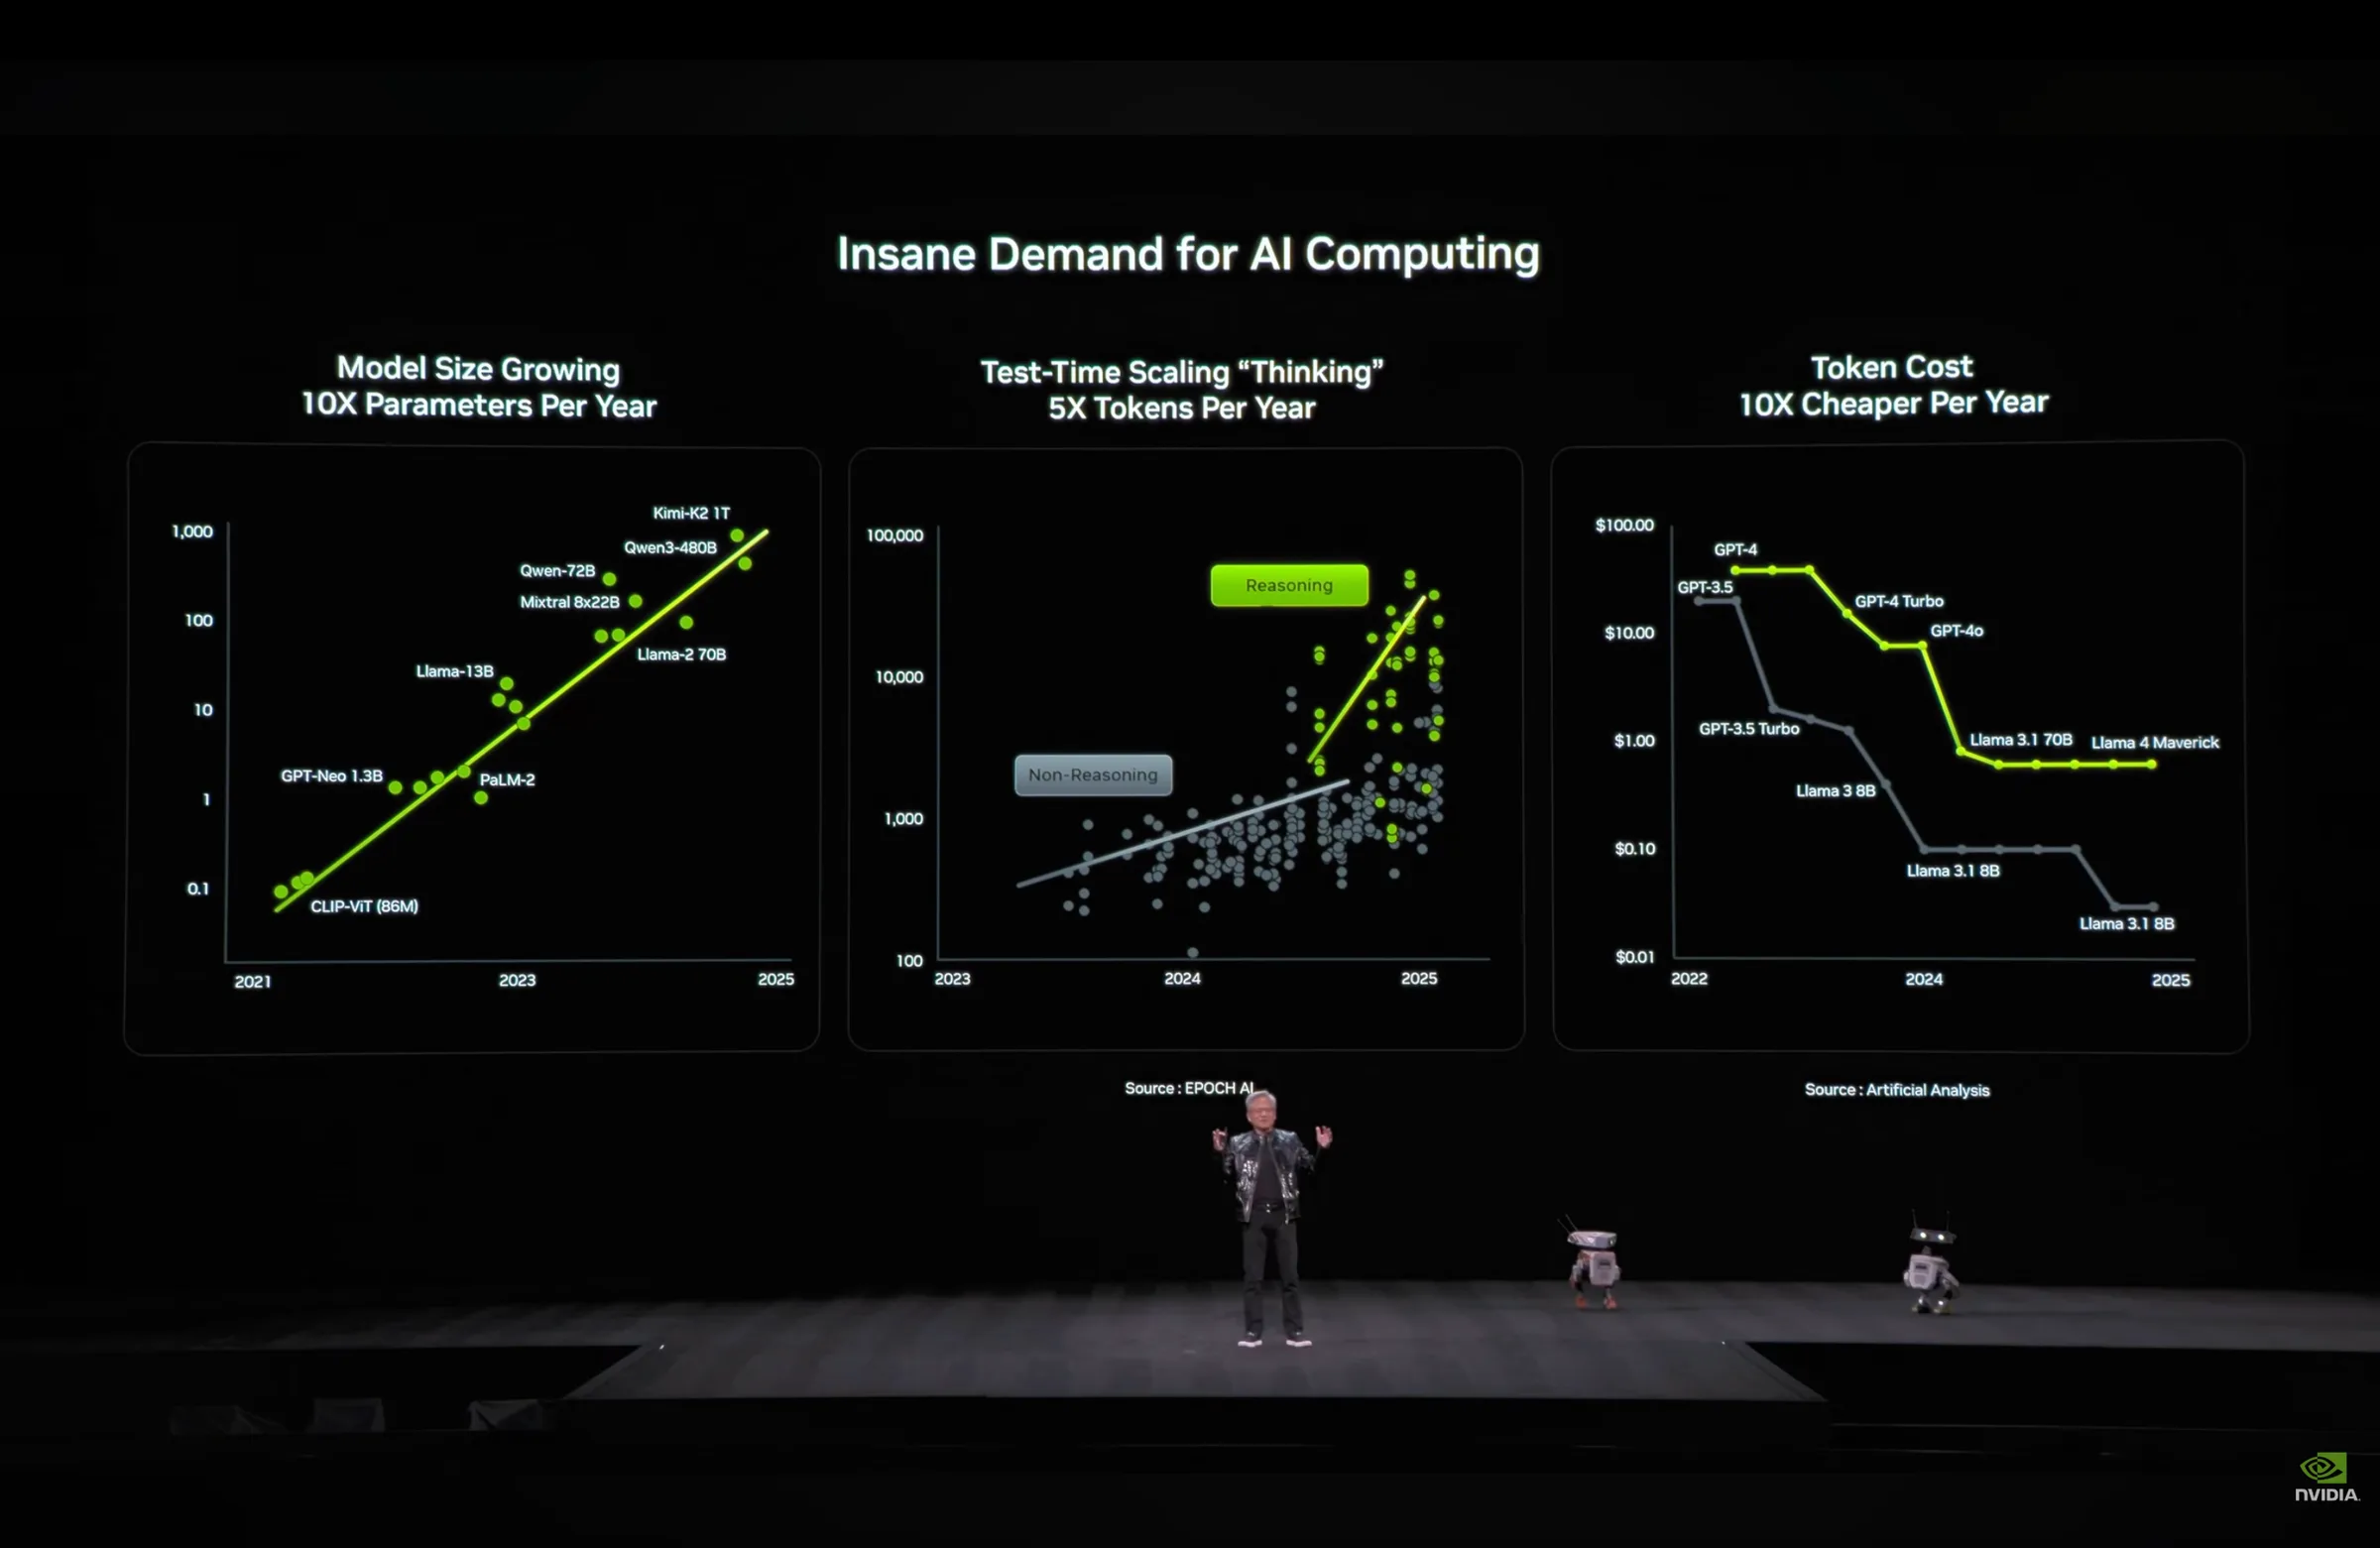
こうした「Agentic Enterprise」の文脈では、推論コストの低下が決定的な意味を持ちます。Vera Rubin がもたらすのは、inference token あたりのコストを前世代の10分の1まで引き下げることです。これにより企業は、リソースを基礎的な演算能力への投資から、本当に価値を生む AI アプリケーションや業務プロセスの設計へと振り向けられるようになります。
プラットフォームが再定義されるとき、AI の可能性も書き換えられる
Vera Rubin の意義は、性能の数字が上がったことだけではありません。AI コンピューティングが新たな段階に入ったことを告げるものです。計算の単位がチップからシステムへ、サーバーから rack へと広がるにつれ、AI が担える役割もまた変わっていきます。
企業がより賢く、より自律的な AI を求めたことが、このプラットフォームを生んだのでしょうか。それとも、プラットフォームの登場が、企業に AI のまったく新しい可能性を思い描かせたのでしょうか。ぜひコメントで教えてください。