【技術シェア】Google Vision API でヤリイカ・アオリイカ・コウイカ・スルメイカを一瞬で見分けて、市場でカモにされない
今回は Google Vision API を使って、ヤリイカ(ケンサキイカ)、アオリイカ、コウイカ、スルメイカを見分ける画像認識モデルを作ってみます。機械学習の知識はあまりないけれど市場へ買い物に行くお母さんにぴったりの内容です。Vision API は Google が提供するサービスで、機械学習モデルを自分で作れない人でも簡単に画像分類器を作れます。
 Khan LeeCTO
今回は Google Vision API を使って、ヤリイカ(ケンサキイカ)、アオリイカ、コウイカ、スルメイカを見分ける画像認識モデルを作ってみます。機械学習の知識はあまりないけれど市場へ買い物に行くお母さんにぴったりの内容です。(その共通部分はたぶん null だとわかっていますが)
前置きはこのくらいにして、Vision API は Google が提供するサービスで、機械学習モデルを自分で作れない人でも簡単に画像分類器を作れます。
機械学習について知りたい方は こちらの記事をどうぞ。

今回の練習は、だいたい次のステップで進めます。
- GCP プロジェクトを作成し、GCP AutoML を有効にする
- 十腕形の軟体動物たちの画像を集める
- GCP で storage bucket を作成し、画像をアップロードする
- AutoML の画面を開き、指を動かすだけでモデルを完成させる
とても簡単でしょう?
始める前に、ヤリイカ、アオリイカ、コウイカ、スルメイカ、そしてタコの違いを知っておくことをおすすめします。こちらの動画がわかりやすいです。
では!まずは GCP の申し込みから。こちらの動画を見ながら一歩ずつ進めてください。
GCP の申し込みが終わったら、AutoML のページで API が有効(Enable)になっているか確認しましょう。
準備ができたら、Google でヤリイカやアオリイカなどの画像を集め、あらかじめ作っておいたフォルダにそれぞれ保存します。フォルダ構成は次のとおりです。
- cuttlefish はコウイカ
- neritic はヤリイカ(ケンサキイカ、小ぶりのものも含む)
- softneritic はアオリイカ
- squid はスルメイカ
- octopus はタコ
画像を集めるときに困ったのが、料理された状態の写真があまりにも多いことです。これでは画像学習の効率が落ちてしまうので、何枚か選んでおきました。一緒にやってみたい方はこちらからダウンロードしてください!
解凍すると、画像入りのフォルダが 5 つと、index.csv、test.py が入っているはずです。
index.csv の中身は次のとおりです。
これは、このあと AutoML に渡すファイルです。
test.py は、ダウンロードした画像を整理して index.csv を作るために書いた Python ファイルです。
私の圧縮ファイルをダウンロード済みなら、おめでとうございます。もう半分終わっています!
ステップ 3 では、GCP Storage に bucket を作成します。名前は次の形式にする必要があります。
<your-project-id>-vcm
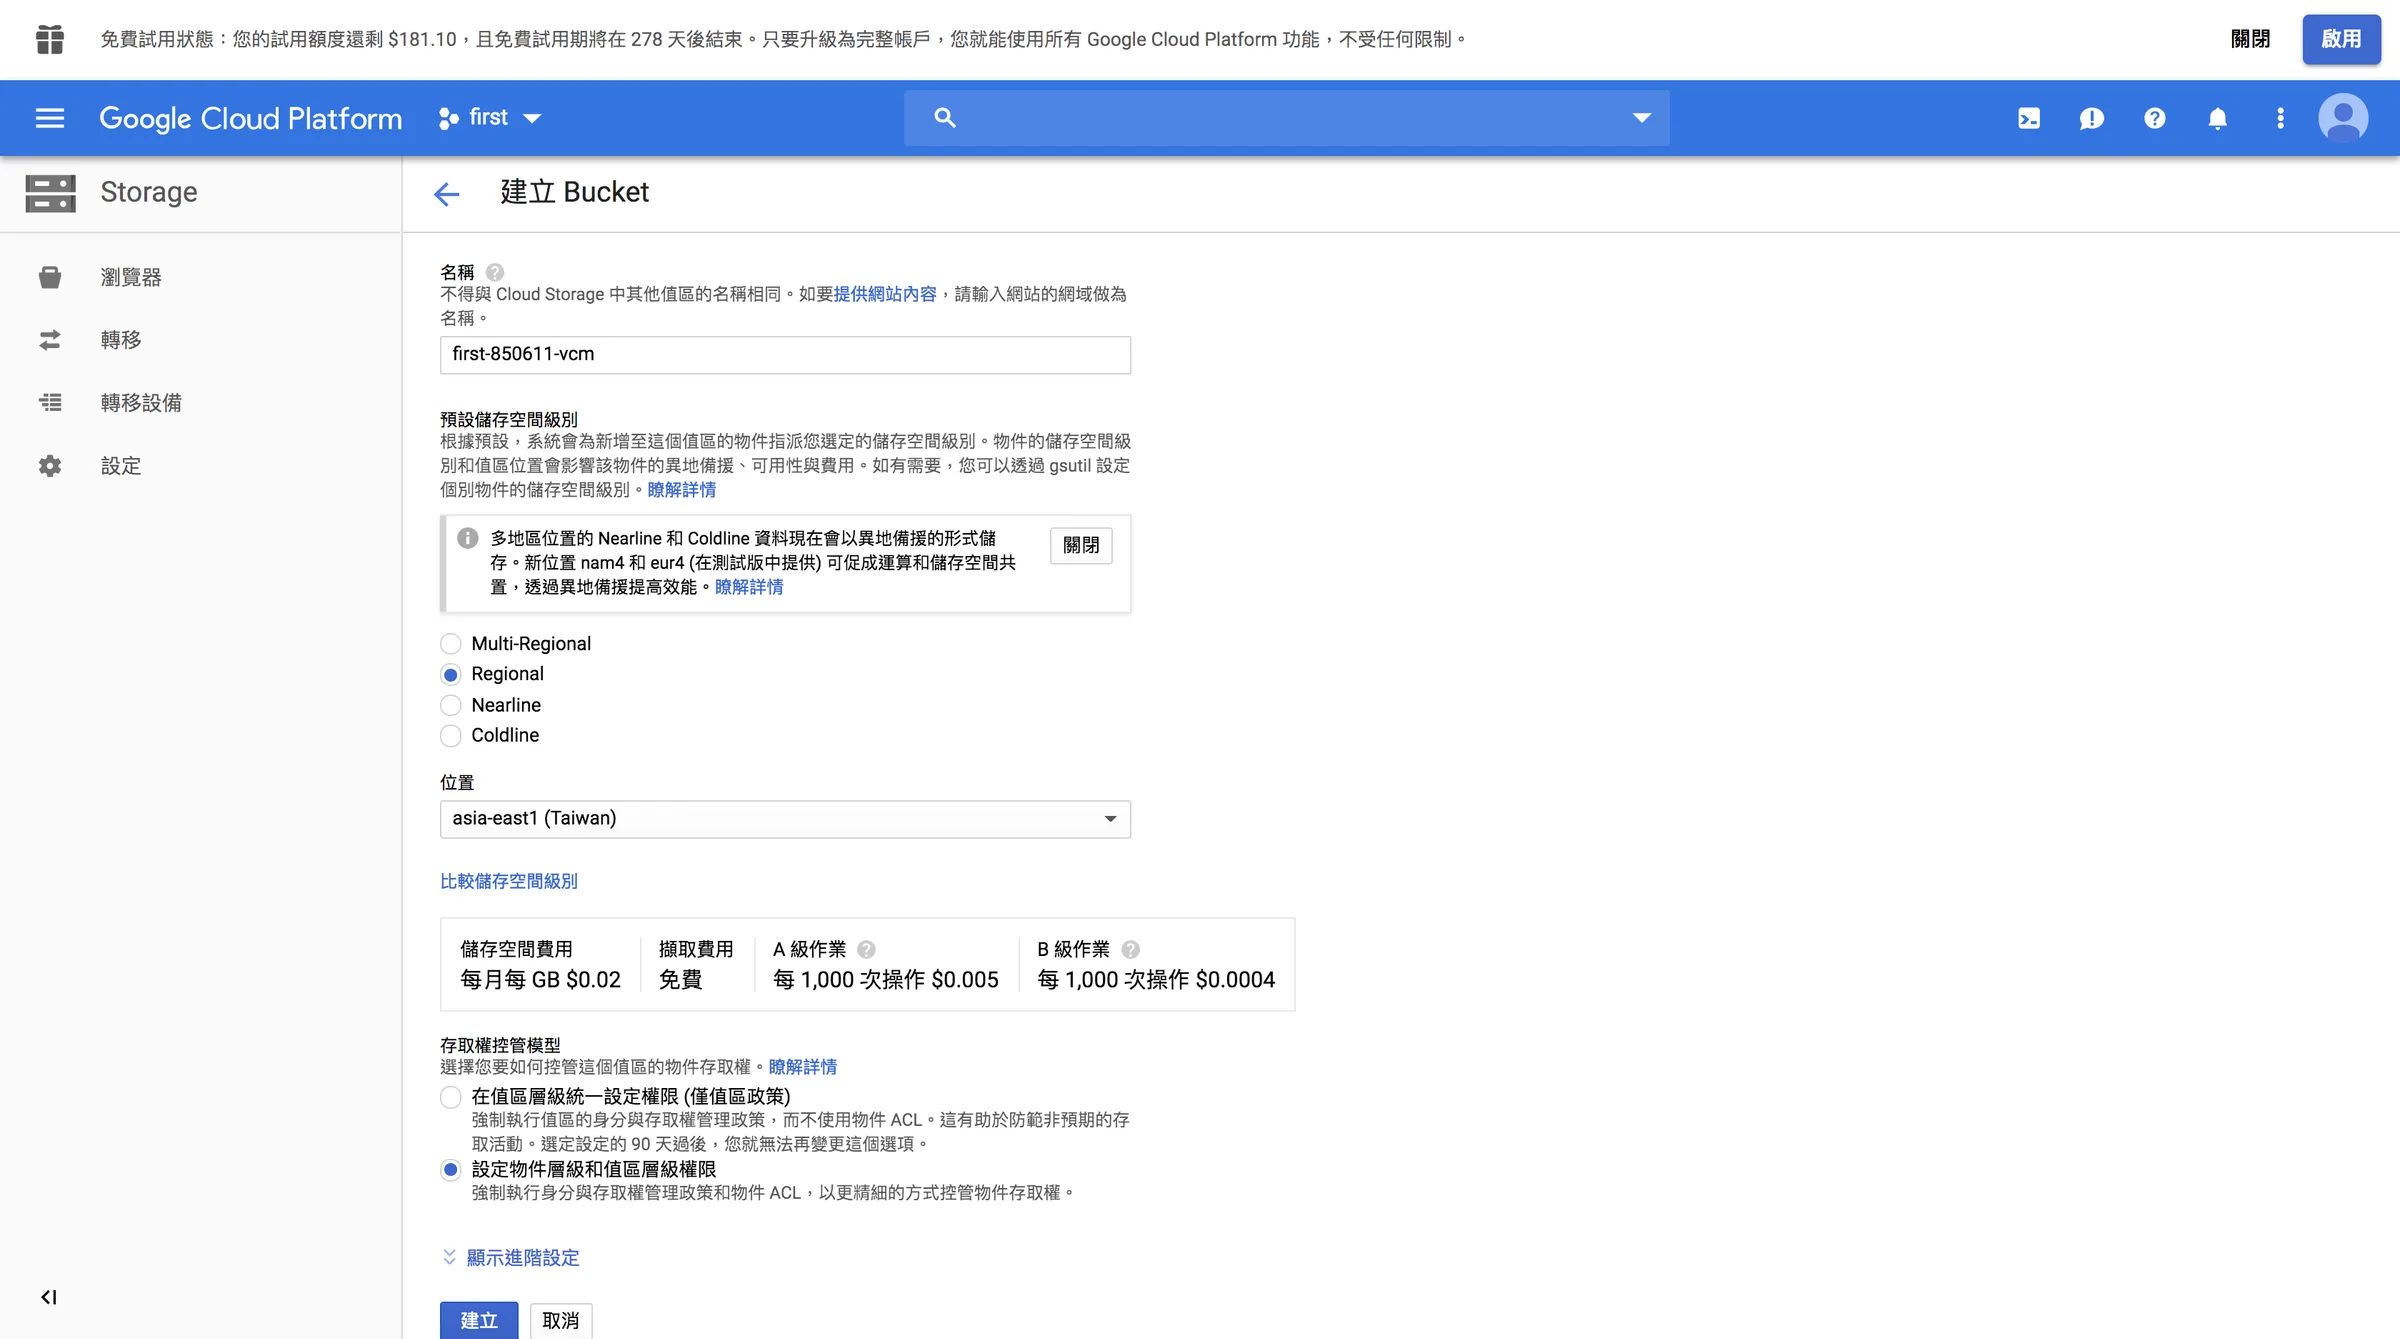
たとえば、私が作成した bucket の名前は first-850611-vcm です。
作成したら、first-850611-vcm の中に seafood というフォルダを作り、cuttlefish、neritic、softneritic、squid、octopus と index.csv をすべて seafood フォルダにアップロードします。
これでステップ 3 は完了です!
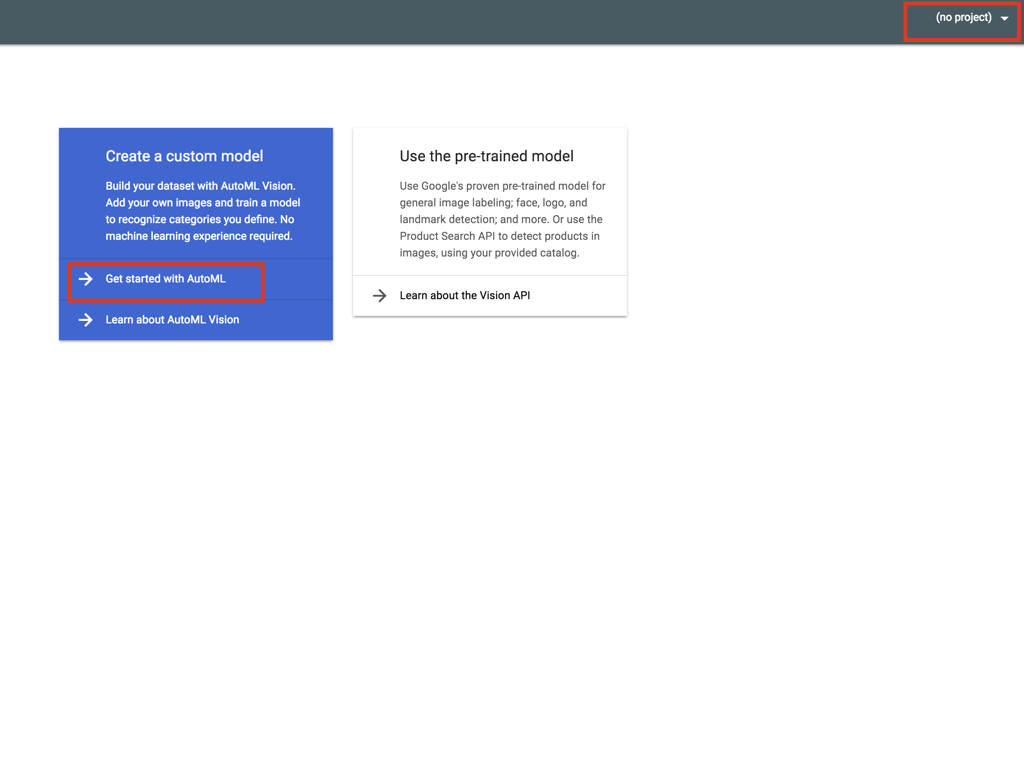
最後のステップです。AutoML のページを開き、右上で自分のプロジェクト名を選んで、Get started with AutoML をクリックします。
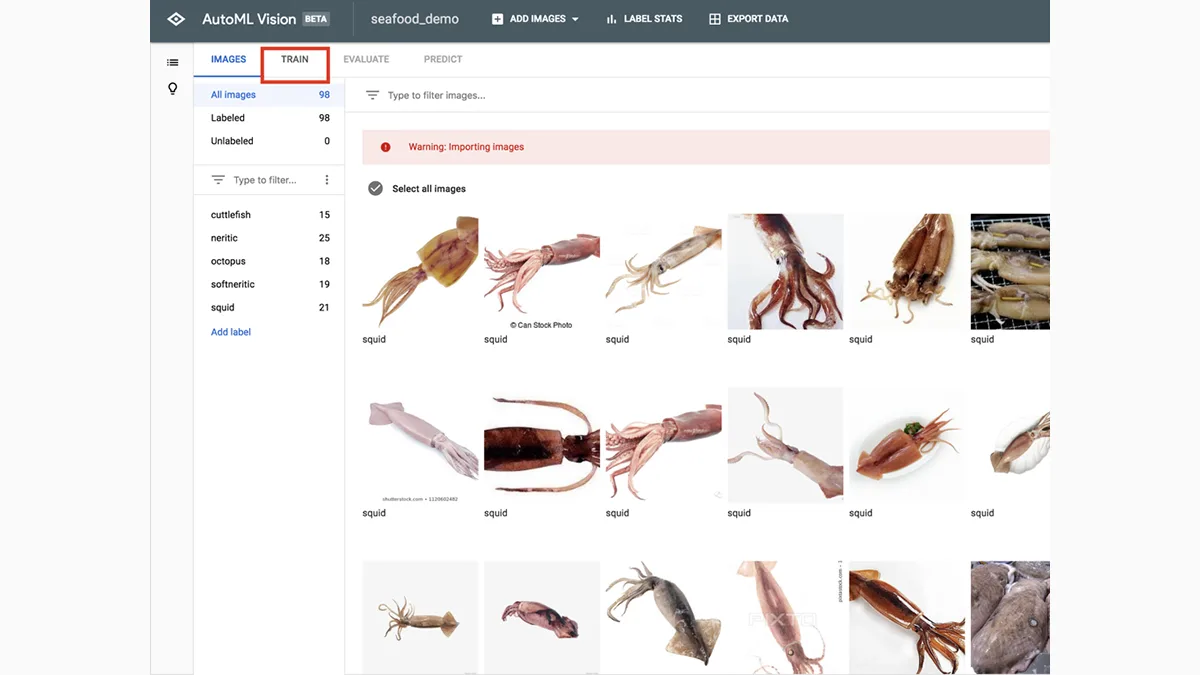
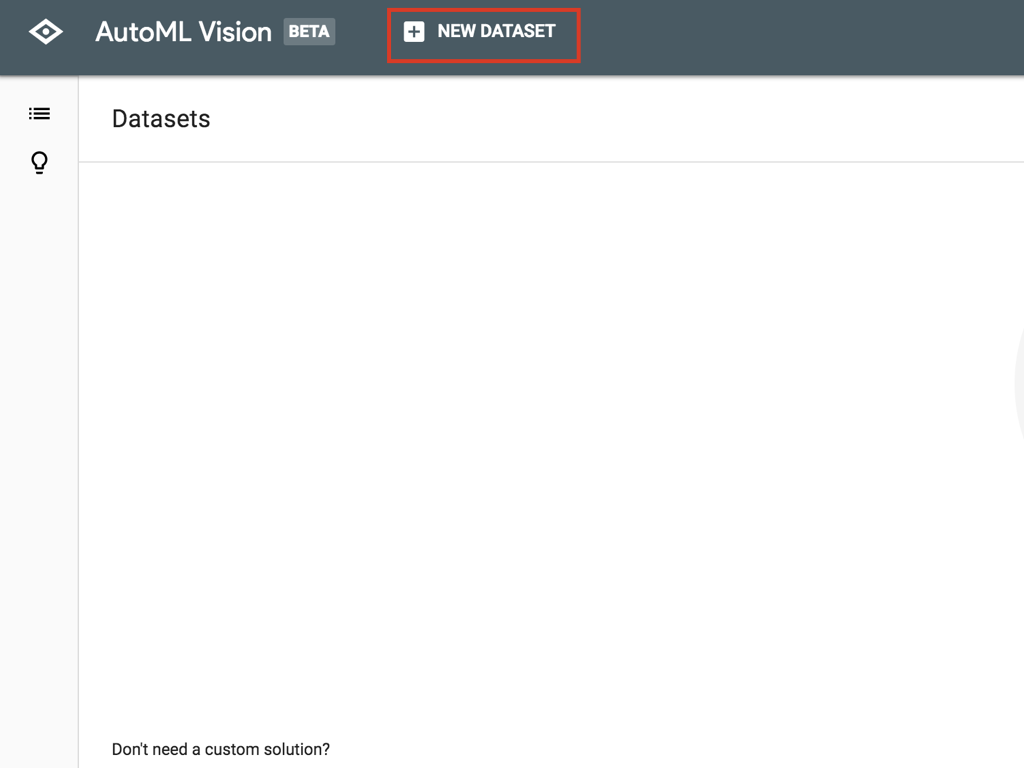
続いて、上部の NEW DATASET をクリックし、学習させるデータを追加します。
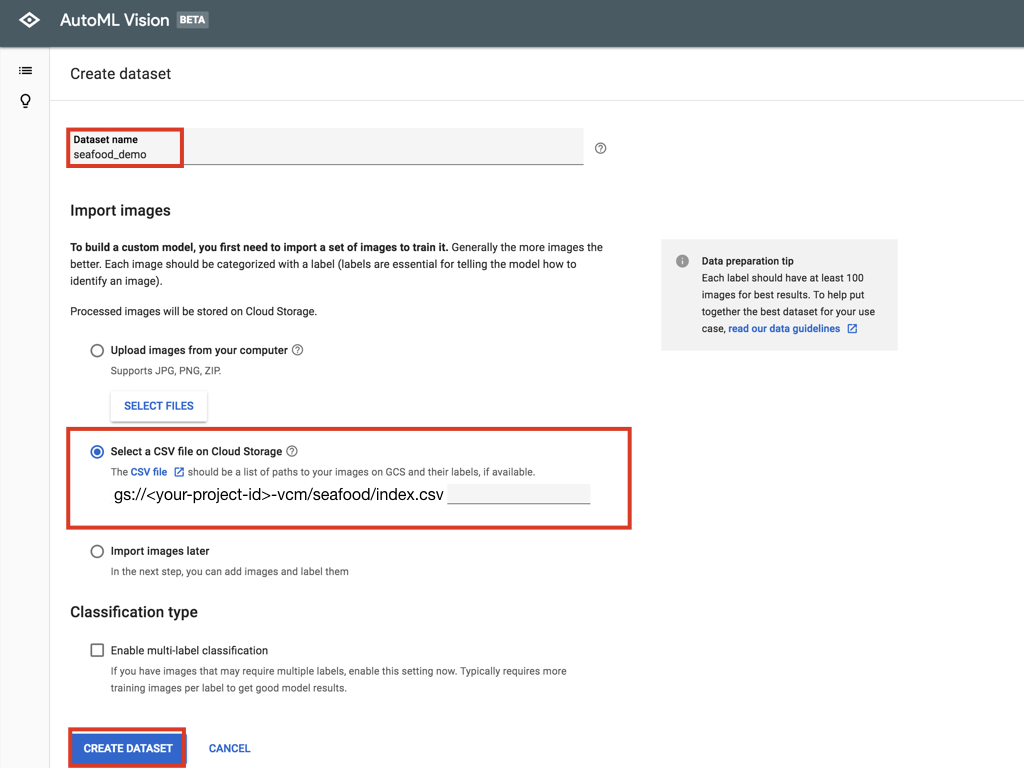
Dataset name を入力します。自分で見分けがつけば何でもかまいません。
次に Select a CSV を選び、次のように入力します。
gs://<your-project-id>-vcm/seafood/index.csv
私の場合なら、次のように入力します。
gs://first-850611-vcm/seafood/index.csv
そして CREATE DATASET をクリックし、学習データのアップロードを待ちます。
アップロードが終わると、学習させる画像とラベルが表示されます!
続けて、上部の TRAIN をクリックして学習を始めます。
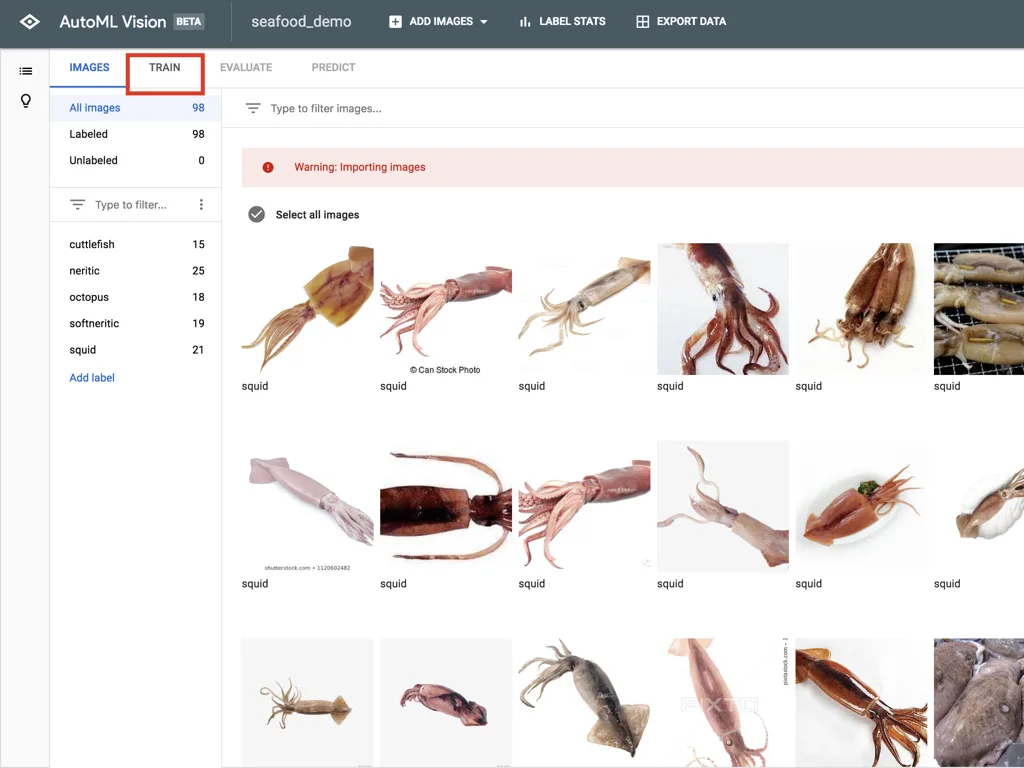
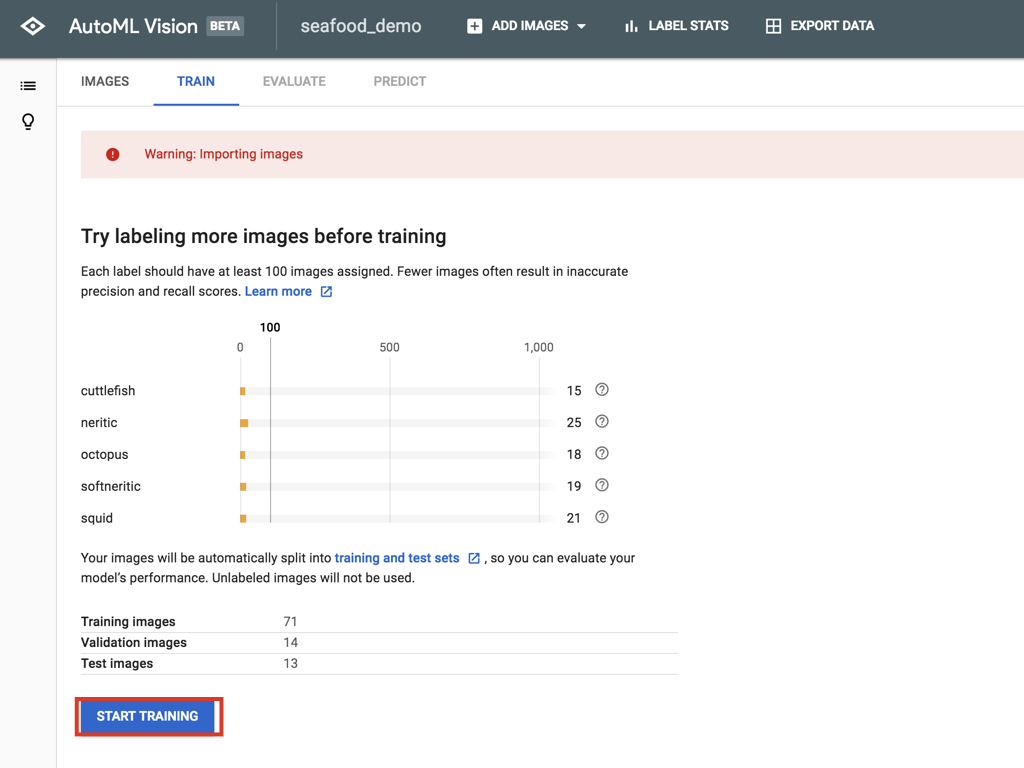
「画像が少なすぎますよ~」といった警告が出ます。
エンジニアたるもの、勝つときは攻め、負けそうなら引く。こういうときは恐れずに押し切って学習させましょう。一緒に勇気を出して START TRAINING をクリック。
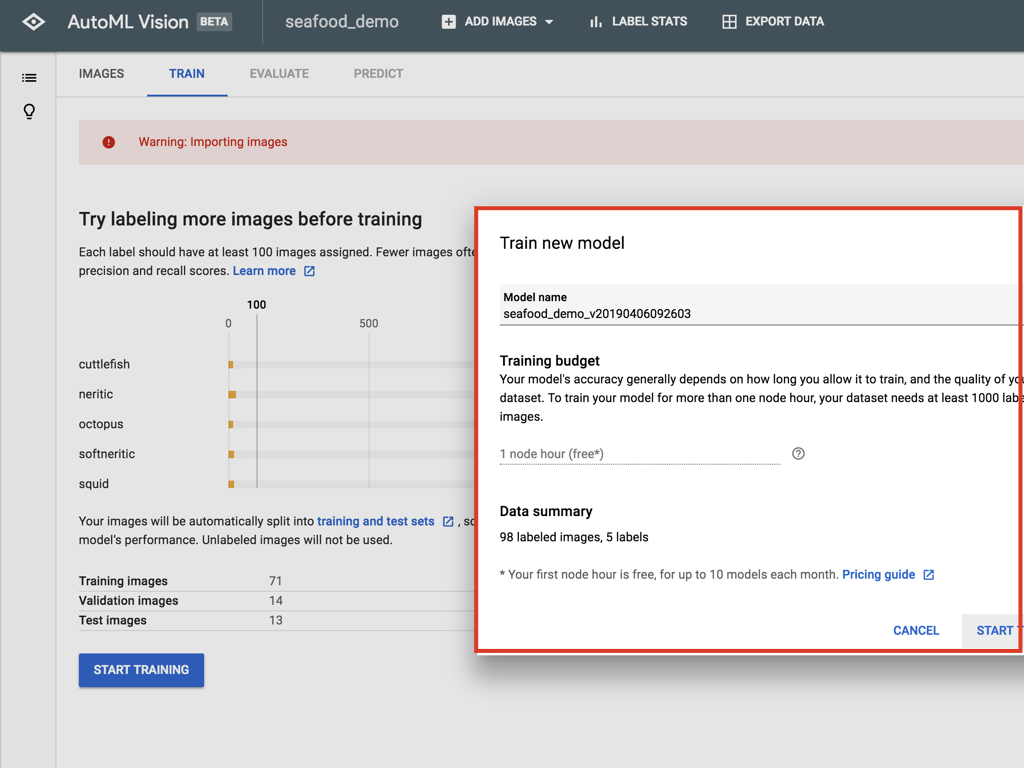
Training budget は free プランを選び、START をクリックします。
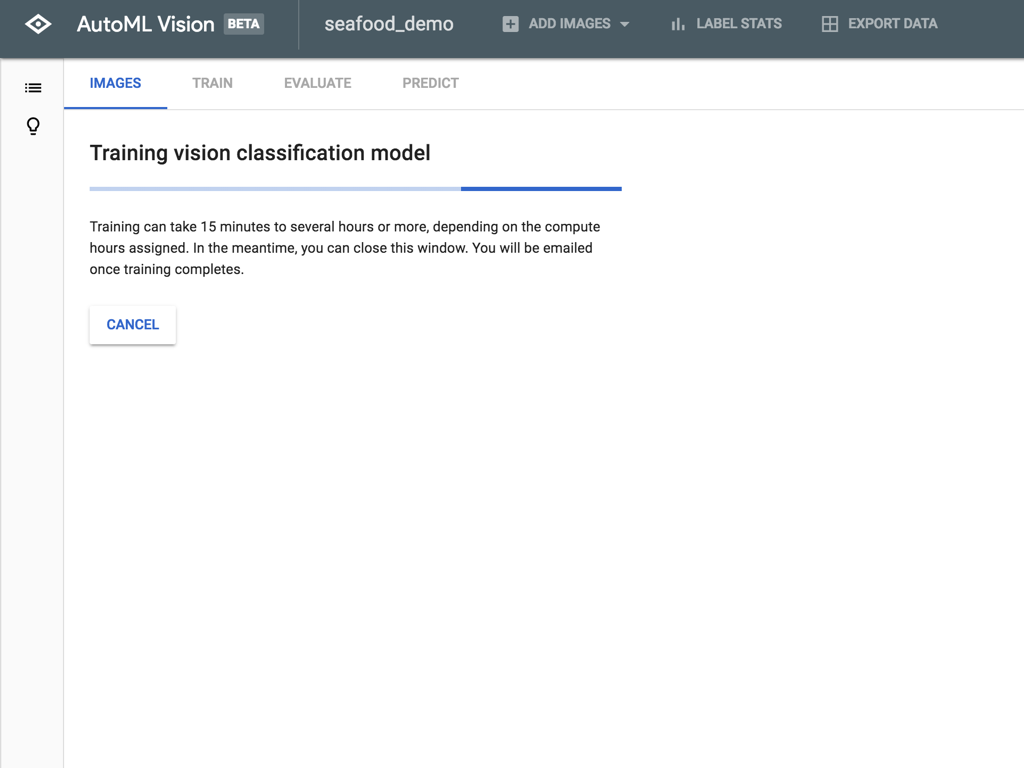
長い待ち時間のあと、model の学習が終わったら、上部の PREDICT をクリックして学習成果をテストできます。
ヤリイカとスルメイカの写真を 1 枚ずつアップロードして、model に判定させてみます。
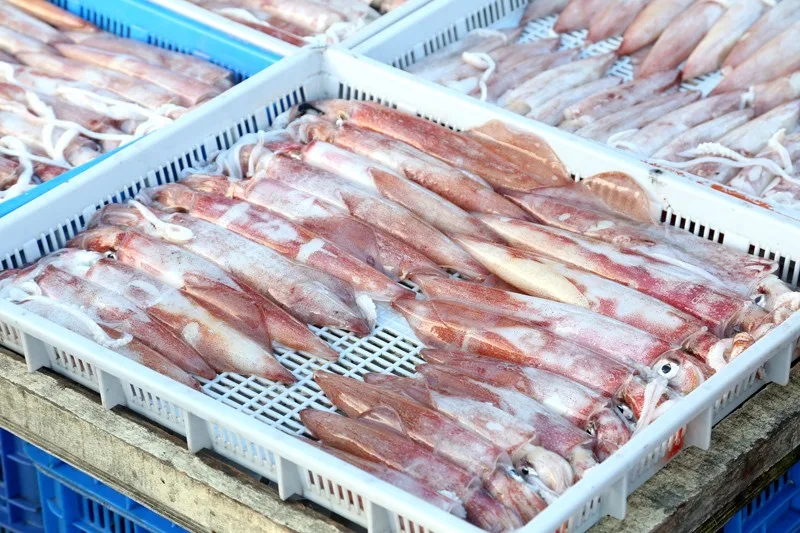
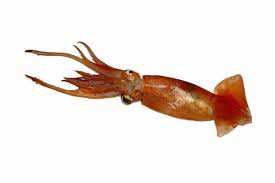
model の予測結果は下の画像のとおりです。
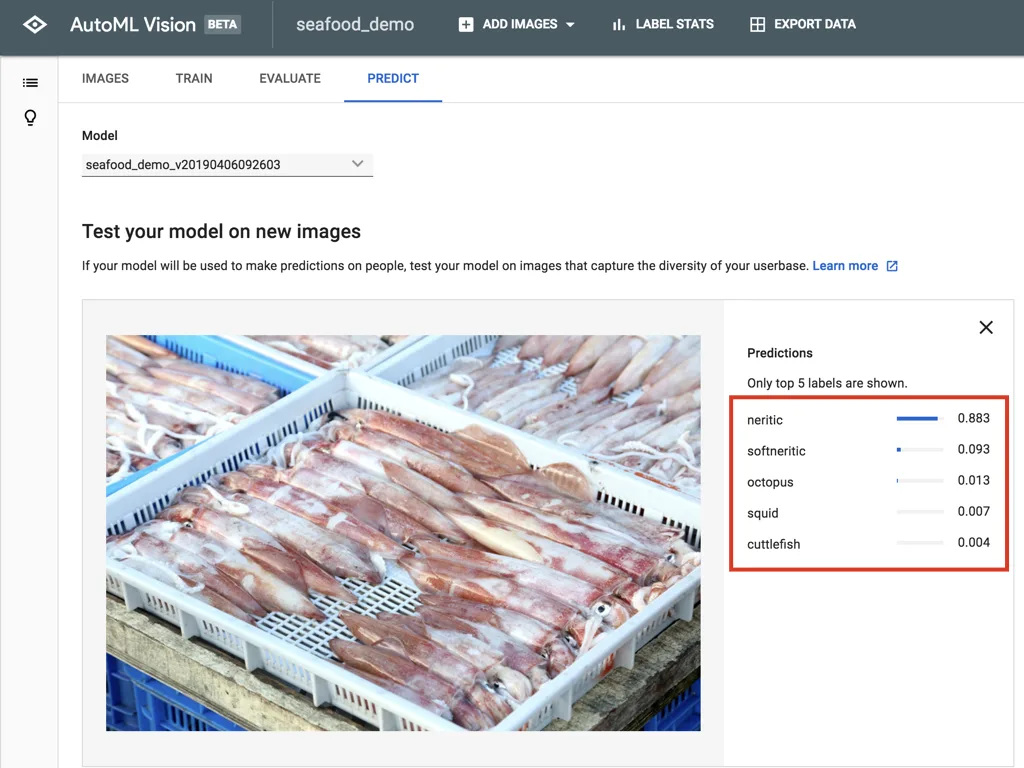
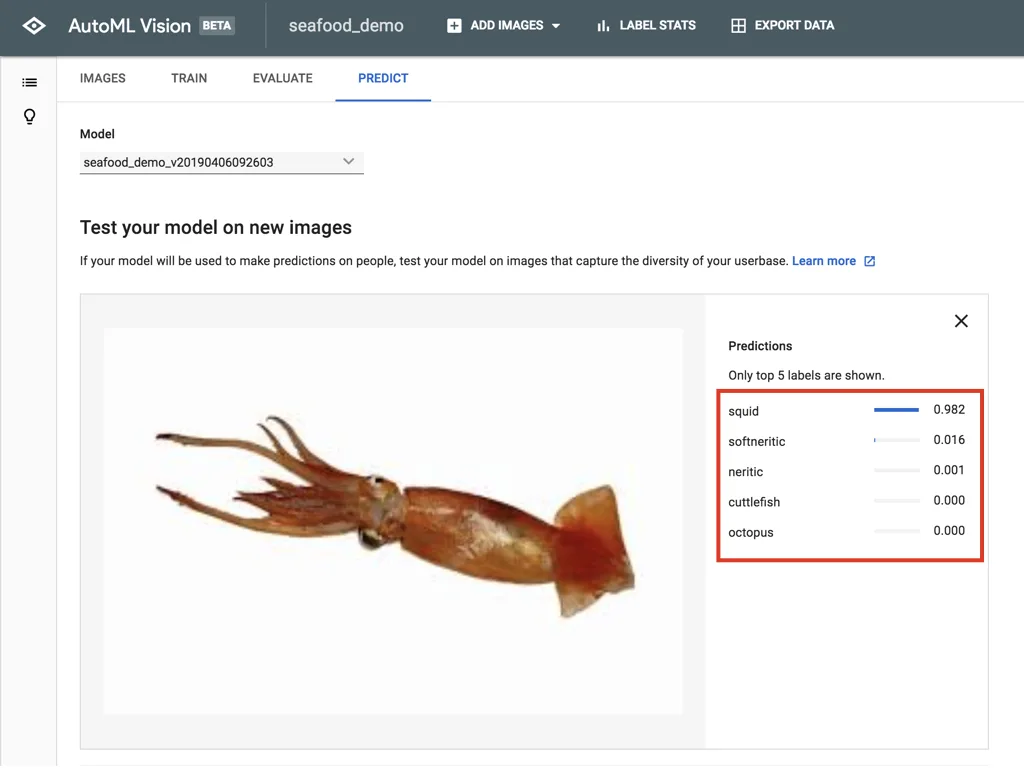
ご覧のとおり、Google は本当にすごい!!!!!!!!!!!
もう機械学習エンジニアなんていらないのでは?機械学習エンジニアはみんな辞めて魚屋になるしかない QQ
さて!認めざるを得ませんが、Vision AutoML は本当に強力です。これほど少ない画像でも、ここまで正確に学習できるのですから。
こんなにおもしろいもの、ここで終わらせるわけにはいきません。次回は、この model の API を連携させて、新米ママが実際に使えるようにする方法を探ります。もうヤリイカのつもりでスルメイカを買ってきて姑に叱られることもありません。嫁姑問題を解決する最強の切り札です!!
ここで宣伝です:
LINE チャットボットに、画像認識、音声認識、さらには動画認識など、機械学習を組み合わせた機能が必要な企業の皆さま、以下のメールアドレスまでお気軽にお問い合わせください。